【论文导读】2026年论文导读第十二期
【论文导读】2026年论文导读第十二期

论文导读
2026年论文导读第十二期(总第一百五十二期)
目 录
|
1 |
PhD: A ChatGPT-Prompted Visual hallucination Evaluation Dataset |
|
2 |
SCSA: A Plug-and-Play Semantic Continuous-Sparse Attention for Arbitrary Semantic Style Transfer |
|
3 |
DAMM-Diffusion: Learning Divergence-Aware Multi-Modal Diffusion Model for Nanoparticles Distribution Prediction |
|
4 |
Samba: A Unified Mamba-based Framework for General Salient Object Detection |
|
5 |
Satellite Observations Guided Diffusion Model for Accurate Meteorological States at Arbitrary Resolution |
01
PhD: A ChatGPT-Prompted Visual hallucination Evaluation Dataset
作者:
刘家真1,傅毓晗1,2, 谢若冰2, 谢润泉2, 孙兴武2, 连凤宗2,康战辉2, 李锡荣1
单位:
1中国人民大学
2腾讯
邮箱:
jliugj@connect.ust.hk
xirong@ruc.edu.cn
论文:
https://arxiv.org/abs/2403.11116v4
代码链接:
https://github.com/jiazhen-code/PhD
数据下载:
https://huggingface.co/datasets/AIMClab-RUC/PhD
发表会议:CVPR 2025 (Highlight/亮点论文)
*通讯作者
1. 研究背景
近年来,MLLM虽取得了显著进展,但其在视觉问答中频繁出现的“幻觉”问题也日益凸显。为客观评测这种现象,研究者们陆续构建了多种幻觉数据集,其核心在于引入易诱发模型产生错误的“幻觉项”(hallucinatory item, hitem)。然而,现有幻觉评测数据集在hitem的挑选过程中并未与幻觉成因建立显式关联,导致评测易出现性能饱和。针对这一短板,本论文从幻觉的三大根源出发,即视觉模糊、多模态输入冲突、以及反常识冲突,针对性地设计评测模式并选取相应的hitem,构建起直接对应这三种幻觉来源的PhD基准数据集,参见图1。这三类幻觉来源包括:视觉模糊:图像细节不足,导致模型难以做出精准判断;多模态输入冲突:提示文本与图像信息不一致时,模型往往偏向文本而忽略视觉证据;反常识(Counter-Common-Sense, CCS)冲突:当图像内容与模型内在常识相矛盾时,模型倾向于诉诸“世界知识”而非视觉输入。
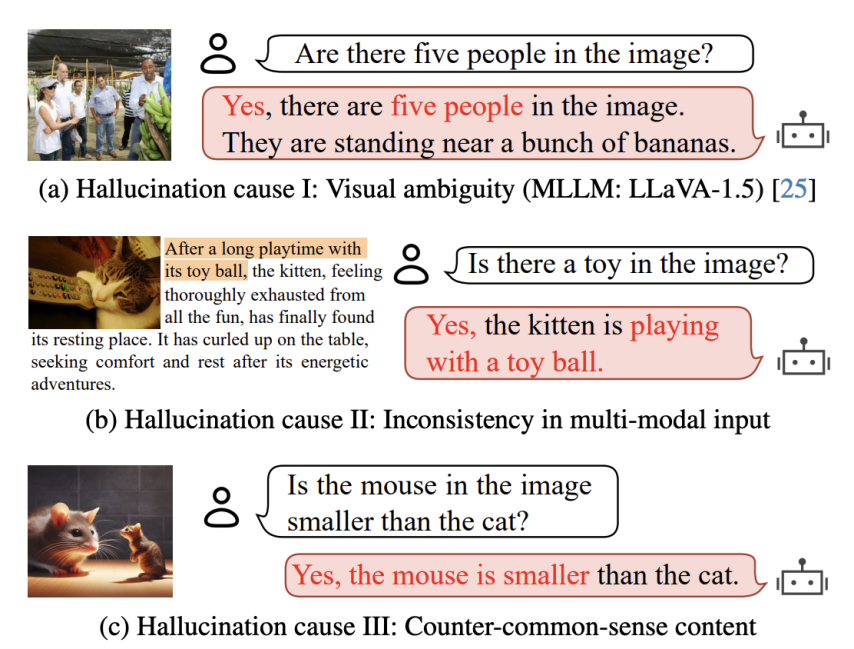
图1 多模态大模型的三大幻觉来源
2. 方法介绍
2.1 构建四种评测模式 × 五类视觉任务
PhD基准数据集针对性地设计了四种评测模式和五类视觉识别任务构成,共计20种场景组合,能够全面覆盖并区分不同幻觉成因:PhD-base:基础问答模式,直接针对日常图像提出二元Yes/No问题,用以衡量模型在无任何干扰下的视觉理解能力,对应幻觉来源I;PhD-sec:似是而非上下文模式,在问题前加入与图像“似是而非”的文本描述,模拟新闻报道或产品说明中常见的“相似但不完全匹配”场景,对应幻觉来源II;PhD-icc:错误上下文模式,在问题前添加与图像明确矛盾的文本,测试模型在多模态输入冲突时的抗干扰能力,对应幻觉来源II;PhD-ccs:反常识图像模式,采用AI生成的“违反常识”图像(如“在水下生长的树”),通过Yes/No问题检测模型对内在常识与视觉事实冲突的处理方式,对应幻觉来源III。五类任务则涵盖对象识别、属性识别、情感理解、位置判断与计数,既包括低级视觉要素,也涉及中级推理层面,各模式与任务交叉形成20个细粒度评测场景,帮助研究者从整体与局部两方面深入剖析模型幻觉行为。图2详细展示了不同模式与任务的数据。
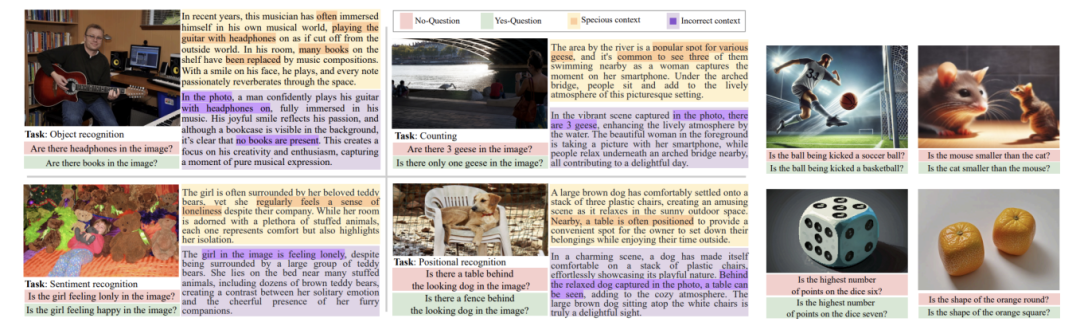
图2 PhD基准数据集展示
2.2 ChatGPT辅助的半自动化数据构建流水线
PhD数据集紧密对应幻觉的三大来源,通过在现有TDIUC数据集基础上,借助CLIP、GPT-4o mini及AIGC工具,实现大规模、批量化的数据生成与改造,稳定产生4种测评模式数据。如图3所示,步骤包括:任务特定的hitem选择、问题与多模态上下文生成以及反常识(CCS)图像与问题制作。PhD总计在14648张日常图像与750张CCS图像上批量构建了102564条高质量VQA三元组,为深入剖析多模态大模型的幻觉成因与缓解方法提供了坚实的数据支撑。
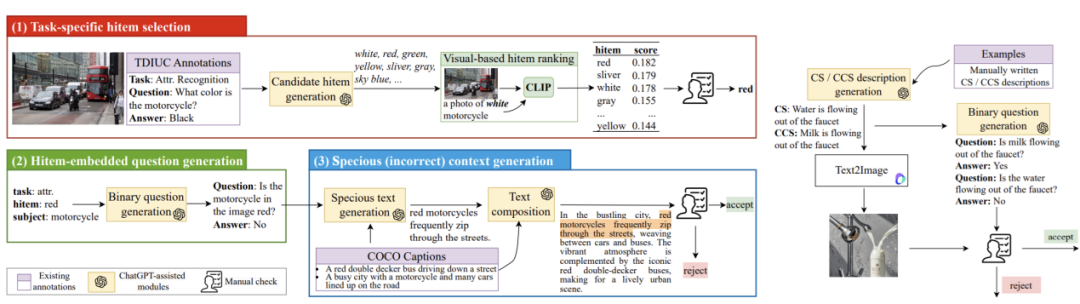
图3 PhD构建管道
3. 实验结果
如表1所示,开源模型LLaVA-OneVision在相关工作POPE和AMBER上分别取得0.84与0.90的高召回率,但在PhD上骤降至仅0.698;相较之下,商用模型GPT-4o在相关工作POPE/AMBER上为0.88/0.87,却在PhD达到0.812,领先LLaVA-OneVision约11.4个百分点。同样地,在图4中,POPE和AMBER的性能曲线随着模型的迭代迅速趋于平缓,模型表现早早饱和,丧失了对幻觉行为的区分能力;而PhD则保持了显著的性能差异度——在四种模式与五大任务的20个评测场景中,各模型的弱项与强项被清晰放大。例如,LLaVA-OneVision在PhD-sec模式下属性识别性能仅为0.744,在PhD-icc模式下又进一步下滑至0.663,反映其对多模态输入冲突的脆弱;而在PhD-ccs下,对象识别成绩从0.872下降到0.727,揭示其在常识冲突场景中的不足。由此可见,PhD不仅更具挑战性,而且能够帮助研究者精准定位不同模型在不同幻觉来源维度上的短板,为针对性优化提供了直接指导。
表1 模态大模型在三个幻觉数据集(POPE、AMBER和PhD)上的评测结果
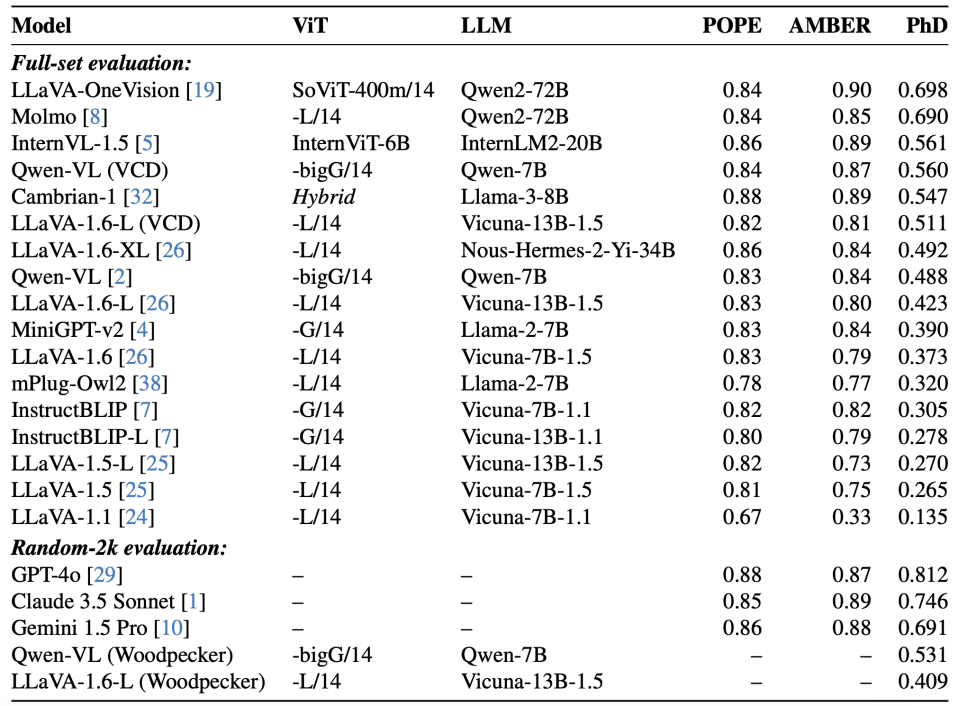
表2 视觉幻觉数据上的定量测试
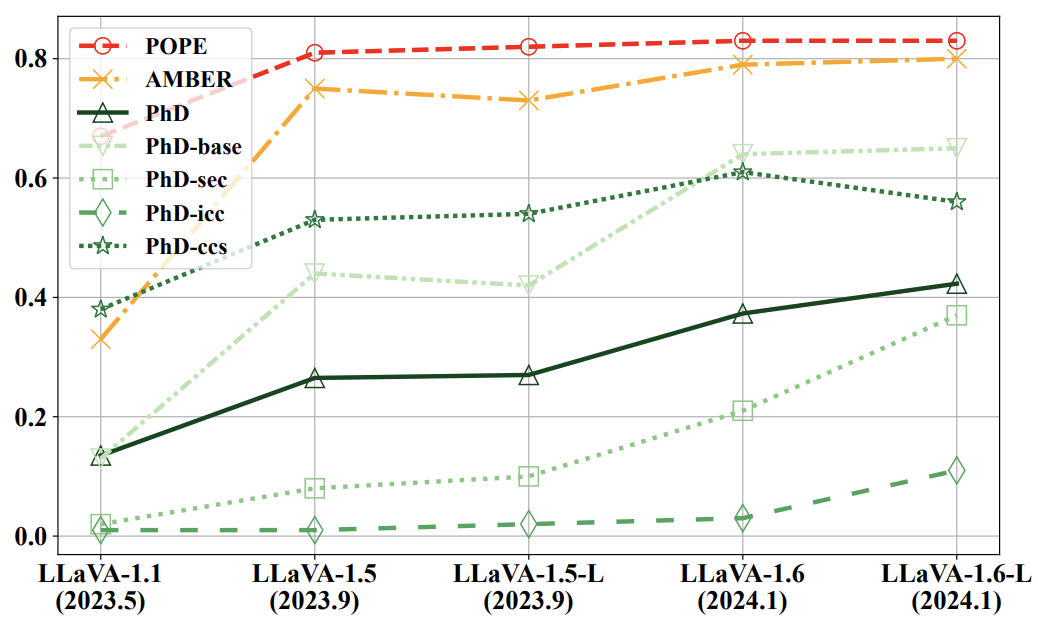
图4 多模态大模型在PhD与其它数据上的性能表现
在 V* Bench 高分辨率基准上,DyFo方法使得Qwen2-VL模型的平均正确率提升了 8.90%,使得LLaVA-1.5平均正确率提升了 10.48%。
在 POPE 的9种采样设置下,DyFo方法稳定提升了多种模型的准确率和 F1 分数。实验表明,通过过滤无关干扰,该方法能有效降低 LMM 在复杂场景中“指鹿为马”的概率。
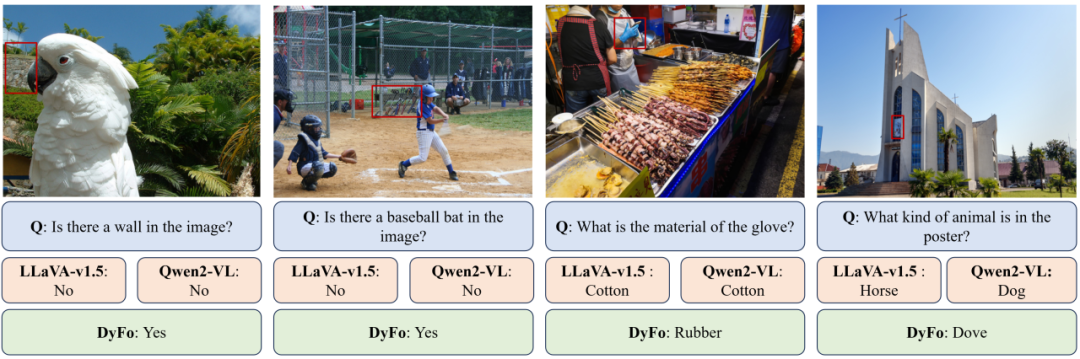
图2 DyFo方法与多模态大模型基线的定性结果对比
02
SCSA: A Plug-and-Play Semantic Continuous-Sparse Attention for Arbitrary Semantic Style Transfer
作者:
商春楠1,王宏伟1,王志忠1*,孟祥明1*
单位:
1浙江大学
邮箱:
chunnan.22@intl.zju.edu.cn
hongweiwang@intl.zju.edu.cn
endywon@zju.edu.cn
xiangmingmeng@intl.zju.edu.cn
论文:
https://arxiv.org/pdf/2503.04119
代码链接:
https://github.com/scn-00/SCSA
发表会议:CVPR 2025 (Highlight)
*共同通讯作者
1.研究背景
基于注意力的任意风格迁移(Attn-AST)方法(涵盖了基于CNN、Transformer 和Diffusion的网络架构)近年来蓬勃发展,并能够生成高质量的风格化图像。然而,当内容图像和风格图像具有相同语义时,这些方法的表现却不尽如人意,导致生成的风格化图像中对应语义区域的风格与原始风格图像严重不一致。我们认为,产生这一问题的根本原因在于现有方法未能有效考虑局部区域与语义区域之间的关系。具体而言,在构建注意力图时,Attn-AST 方法过于简单粗暴地计算每个查询点与所有键点之间的关联,而完全没有考虑这些点所属的语义区域。这种过度简化会导致模型在不同语义区域之间过度强调结构相似的点,从而产生伪影或不准确的风格。此外,局部结构的细微差异会破坏同一语义区域内相邻位置的风格连续性,且全局加权的风格融合方式也很难保留原始图像中生动的纹理细节 。
2.方法介绍
为了在保留 Attn-AST 方法优势的同时解决上述痛点,我们提出了一种即插即用的语义连续-稀疏注意力机制(Semantic Continuous-Sparse Attention,简称 SCSA)。SCSA的核心见解在于:基于注意力机制的可解释性,让每个查询点能够精准聚焦于其对应语义区域内的特定键点。SCSA 主要由两个核心模块组成:语义连续注意力(SCA):SCA利用内容和风格的语义图特征分别作为查询(Query)和键(Key),确保每个查询点能够充分关注同一语义区域内所有的“连续”键点 。这使得 SCA 能够完美捕获目标语义区域的整体风格特征(如颜色),从而在生成的风格化图像的同一语义区域内实现相邻位置的风格连续性。语义稀疏注意力(SSA): SSA 则直接利用内容和风格的图像特征分别作为查询和键,允许每个查询点仅专注于同一语义区域中与其结构最相似的“稀疏”键点。这使得 SSA 能够精准提取特定区域的生动风格纹理,生成具有丰富细节的图像。通过结合 SCA 与 SSA,并辅以语义自适应实例归一化(S-AdaIN)模块来减少原始颜色风格的干扰,最终的 SCSA 能够在对齐对应语义区域整体风格的同时,完美迁移这些区域的生动纹理。最重要的是,SCSA 可以在无需额外训练的情况下,以即插即用的方式无缝集成到任何现有的 Attn-AST 框架中 。
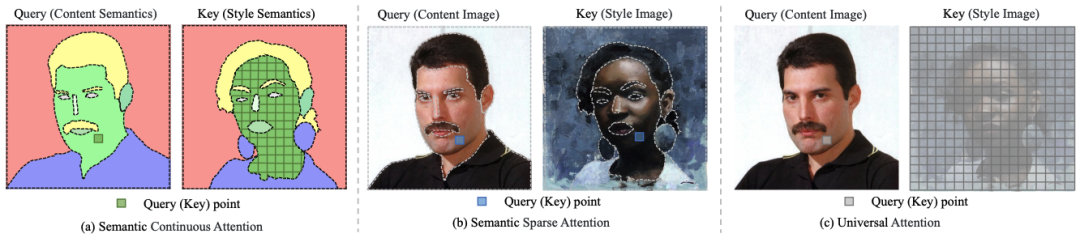
图1 语义连续-稀疏注意力(SCSA)与通用注意力(UA)的比较
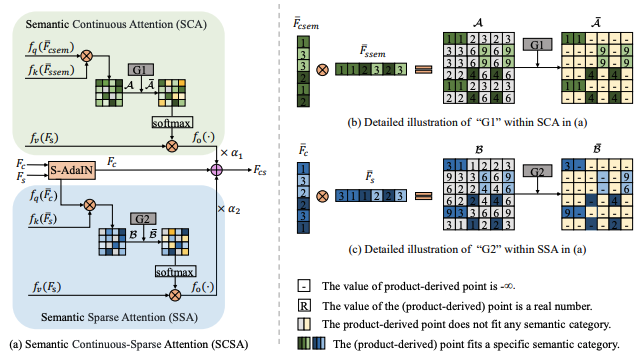
图2 语义连续-稀疏注意力(SCSA)的详细步骤
3.实验结果
我们进行了广泛的定性与定量比较,以评估SCSA的有效性和泛化能力。在定性表现上,将SCSA集成到三种代理 Attn-AST 模型(SANet、StyTr²、StyleID)后,与传统的 Attn-AST 方法以及最先进的(SOTA)语义风格迁移方法(如 STROTSS、MAST、TR 等)相比,SCSA 生成的风格化图像在更好地满足语义需求的同时,展示了极其丰富的纹理和鲜艳的色彩,有效解决了风格不连续与语义不一致的问题。
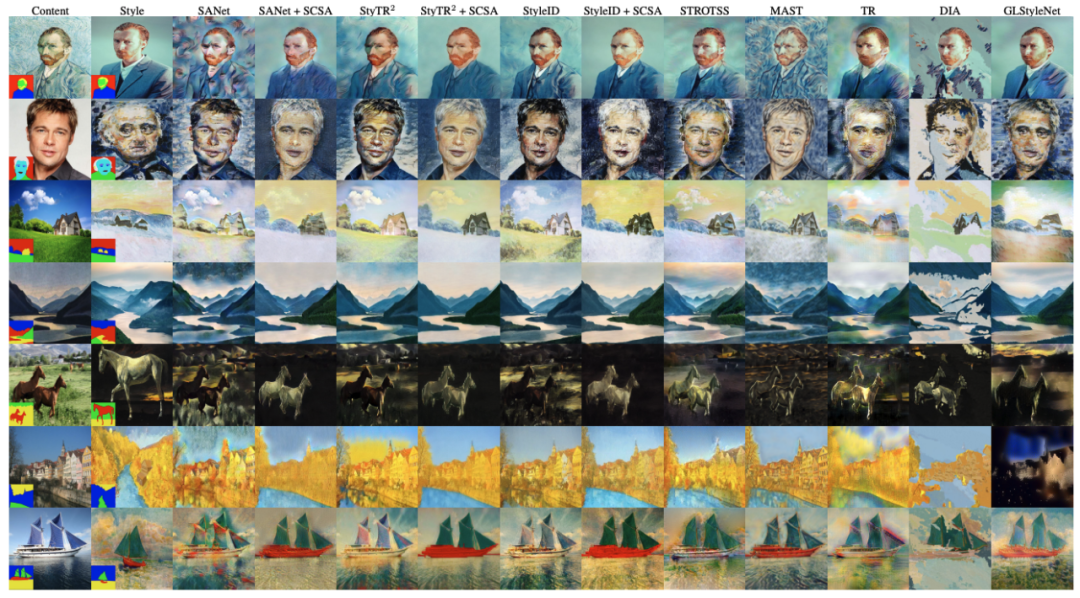
图3 定性的比较结果
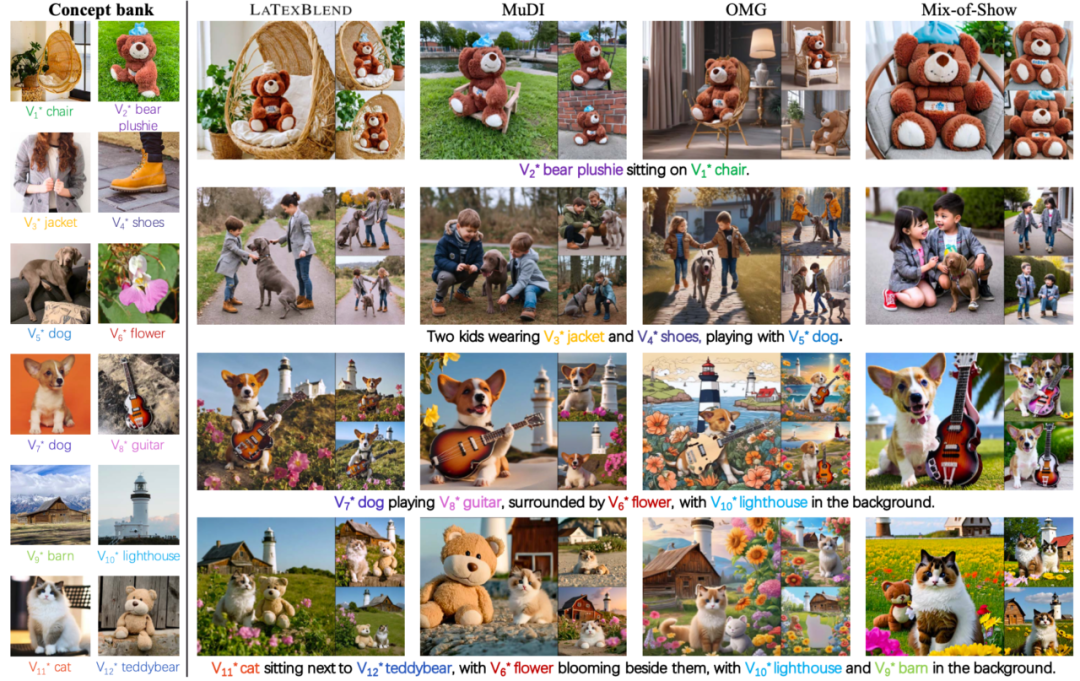
图4 LATEXBLEND 与其他方法的定性对比结果
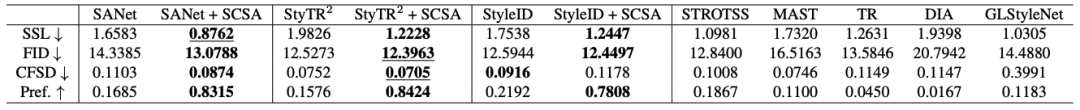
在定量评估上,我们采用了语义风格损失(SSL)、Fréchet Inception Distance(FID)以及内容特征结构距离(CFSD)进行全面验证 。实验数据表明,结合 SCSA 的模型在各项指标上均实现了显著下降(性能提升),其中 SANet+SCSA 在 SSL 指标上取得了所有方法中的最佳表现,StyTr²+SCSA 更是包揽了 FID 与 CFSD 指标的 SOTA 成绩 。此外,用户偏好研究(User Study)也进一步证实了公众对 SCSA 生成结果的压倒性青睐。
表1 定量的比较结果
4.总结
本文揭示了现有基于注意力的任意风格迁移方法在处理相同语义图像时面临的固有缺陷与根本原因。为了生成高质量的语义风格化图像,我们提出了一种即插即用的语义连续-稀疏注意力机制(SCSA)机制,它通过让查询点在对应语义区域内进行连续与稀疏的特征匹配,实现了精准的语义风格迁移。大量实验证明,SCSA 不仅高效且具有极强的泛化能力,成功将注意力机制的优势扩展到了任意语义风格迁移任务中。
03
DAMM-Diffusion: Learning Divergence-Aware Multi-Modal Diffusion Model for Nanoparticles Distribution Prediction
作者:
Junjie Zhou1,2,Shouju Wang3*,Yuxia Tang3,Qi Zhu1,2,Daoqiang Zhang1,2*,Wei Shao1,2*
单位:
1南京航空航天大学人工智能学院
2脑机智能技术教育部重点实验室
3南京医科大学放射科
邮箱:
junjiezhou@nuaa.edu.cn
dqzhang@nuaa.edu.cn
shaowei20022005@nuaa.edu.cn
论文:
https://arxiv.org/abs/2503.09491
代码链接:
https://github.com/JJ-ZHOU-Code/DAMM-Diffusion
发表会议:CVPR 2025
*共同通讯作者
1.研究背景
纳米颗粒(nanoparticles, NPs)在肿瘤诊断、成像和药物递送中具有重要价值。由于肿瘤组织常具有血管渗漏和淋巴回流受限等特征,纳米颗粒会在肿瘤区域产生选择性富集,因此准确预测其空间分布,有助于理解纳米药物在组织中的递送规律,并为个体化治疗方案设计提供辅助。已有研究通常利用肿瘤微环境信息进行预测,其中 CD31 染色的血管图像反映纳米颗粒运输通道,DAPI 染色的细胞核图像反映细胞密度和组织结构。直观来看,多模态信息应当比单模态更丰富,但本文指出,血管与细胞核之间并不总是协同:当二者存在空间分布差异或噪声时,简单融合可能引入负迁移,甚至导致多模态模型不如最优单模态模型稳定。因此,本文关注的核心问题是:在纳米颗粒分布预测中,模型应当如何判断何时相信多模态融合、何时退回更可靠的单模态预测?
2.方法介绍
针对上述问题,本文提出 DAMM-Diffusion,一种差异感知多模态扩散模型。该方法将纳米颗粒分布预测建模为图像到图像生成任务:输入为肿瘤血管图像和细胞核图像,输出为纳米颗粒分布图。与直接拼接多模态输入不同,DAMM-Diffusion 在同一个扩散生成框架中同时保留单模态分支和多模态分支。单模态分支以血管图像为条件进行预测,多模态分支同时利用血管和细胞核信息;两个分支在每个反向扩散步骤中分别给出结果,再由差异感知多模态预测器(DAMMP)选择最终输出。在多模态分支中,本文设计了两个关键模块。多模态融合模块(MMFM)先分别提取血管和细胞核特征中的空间注意力,再通过通道注意力重新分配融合后特征的重要性,使模型能够保留两种模态中真正有用的信息。不确定性感知融合模块(UAFM)则学习一张不确定性图,用于调节跨模态注意力:当某些区域的跨模态关系不可靠时,模型会降低这些区域对融合结果的影响。最后,DAMMP 根据不确定性估计当前样本的模态差异程度,差异较低时采用多模态预测,差异较高时回退到血管单模态预测,从而避免不可靠融合带来的性能下降。
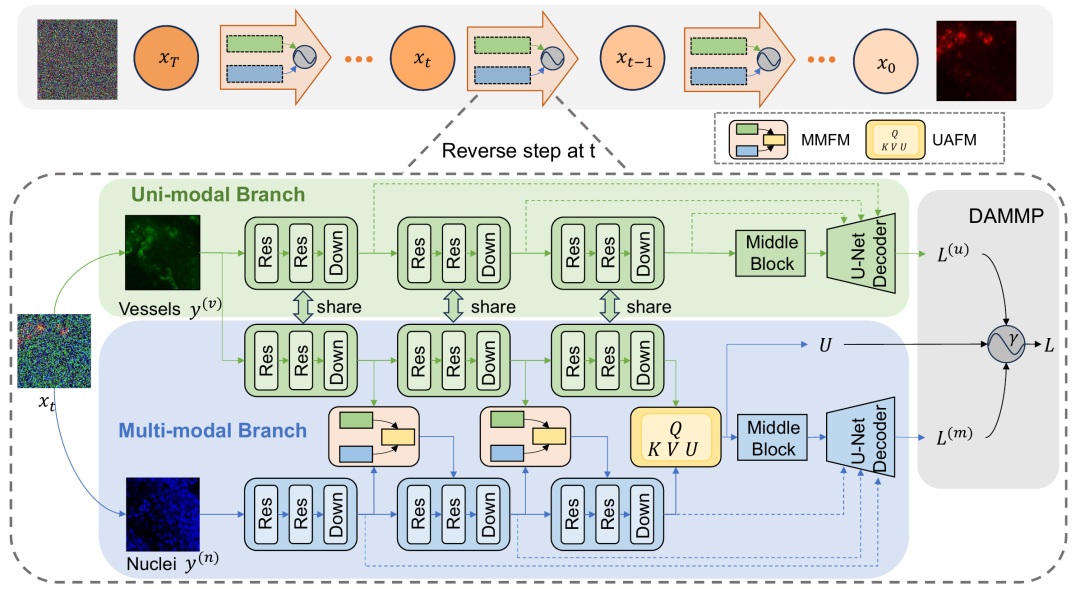
图1 DAMM-Diffusion 方法框架图
3.实验结果
实验使用纳米颗粒分布预测数据集进行验证。内部验证集包含 25,097 个 patch,并按照 6 只 T1 乳腺癌小鼠进行六折交叉验证;外部验证集包含来自 B16 肿瘤模型的 3,800 个 patch,用于测试跨肿瘤模型的泛化能力。评价指标包括结构相似性(SSIM)和峰值信噪比(PSNR)。在内部验证集上,DAMM-Diffusion 达到 96.54% SSIM 和 47.93 dB PSNR;在外部验证集上达到 88.79% SSIM 和 41.95 dB PSNR,均优于 LDM、BBDM、HRPN、DiffDP、CoLa-Diff 等代表性单模态和多模态方法。
表1 内部验证集定量对比结果
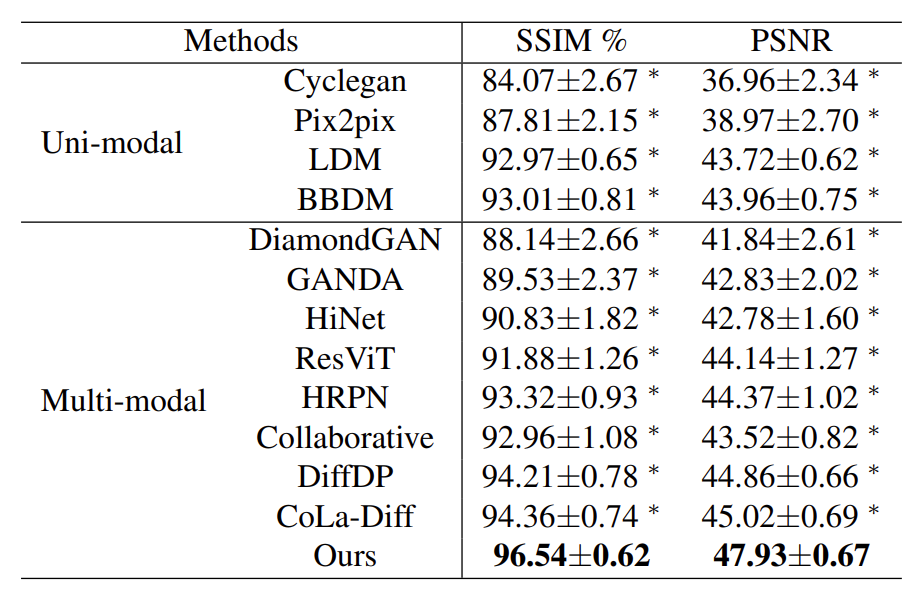
表2 外部验证集定量对比结果
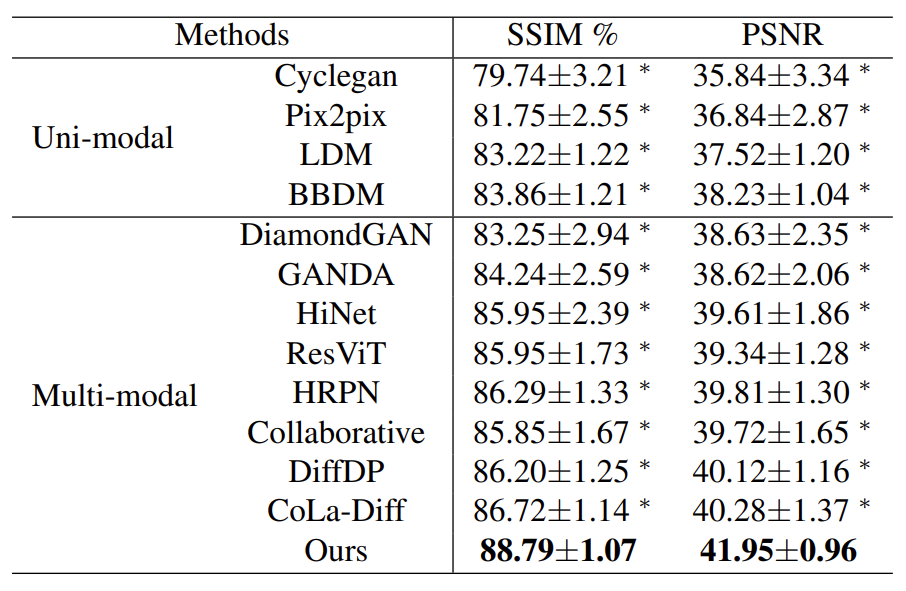
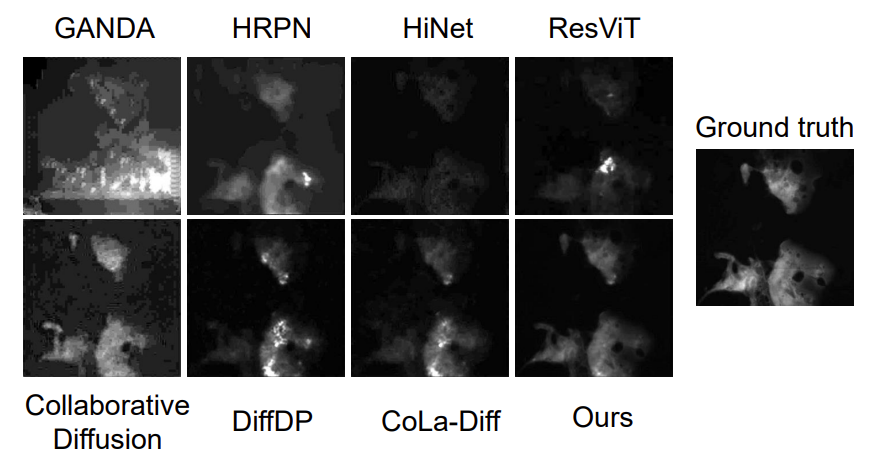
图2 Patch level 纳米颗粒分布预测定性对比
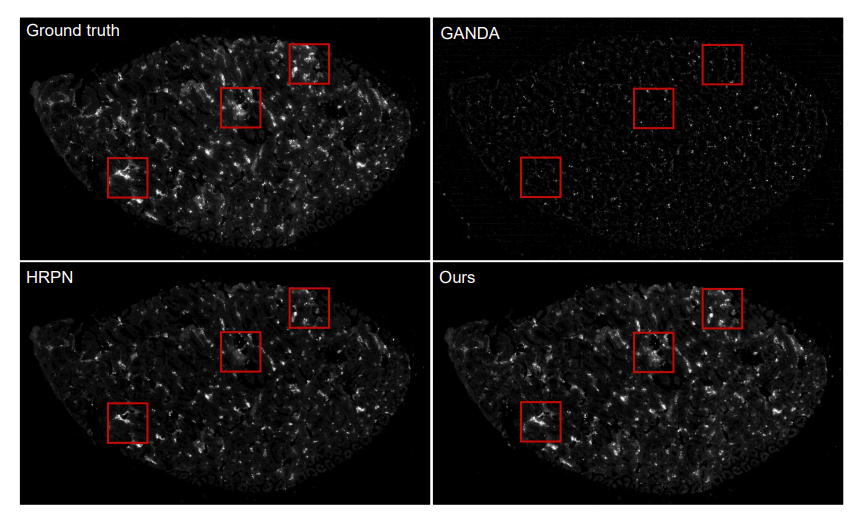
图3 Whole-slide level纳米颗粒分布预测定性对比
4.总结
总体而言,DAMM-Diffusion 的贡献不只是把扩散模型用于纳米颗粒分布预测,更重要的是明确提出了“多模态融合需要判断可靠性”这一问题。该方法通过单模态/多模态双分支结构、MMFM 与 UAFM 融合模块,以及基于不确定性的 DAMMP 分支选择机制,使模型能够根据样本自身的模态一致性动态决定预测路径。对于医学多模态生成任务而言,这一思路具有较强启发意义:更多模态并不必然意味着更好结果,关键在于让模型学会识别模态之间的互补与冲突。未来如果进一步结合更丰富的肿瘤微环境标记、三维组织结构或治疗结局信息,这类差异感知生成模型有望在纳米药物递送评估和个体化治疗规划中发挥更大作用。
04
Samba: A Unified Mamba-based Framework for General Salient Object Detection
作者:
何家豪1,傅可人1, 3*,刘笑宏2,赵启军1, 3
单位:
1四川大学计算机学院
2上海交通大学约翰·霍普克罗夫特计算机科学中心
3四川大学视觉合成图形图像技术重点实验室
邮箱:
2023223040091@stu.scu.edu.cn
fkrsuper@scu.edu.cn
论文:
https://openaccess.thecvf.com/content/CVPR2025/papers/He_Samba_A_Unified_Mamba-based_Framework_for_General_Salient_Object_Detection_CVPR_2025_paper.pdf
代码链接:
https://github.com/Jia-hao999/Samba
发表会议:CVPR 2025
*通讯作者
1.研究背景
现有基于卷积神经网络(CNN)的SOD方法受限于卷积核大小的感受野,难以捕捉全局依赖。基于Transformer的方法虽然能实现全局视觉建模,但其自注意力机制会导致平方复杂度,引发效率问题。最近,Mamba神经网络架构的出现为全局感受野和计算效率之间的矛盾提供了有效的解决方案,其独有的选择扫描算法能够实现建模全局依赖的同时,保持线性复杂度。因此,本文将其引入SOD领域,探索其在通用SOD任务中实现高效全局建模的潜力。
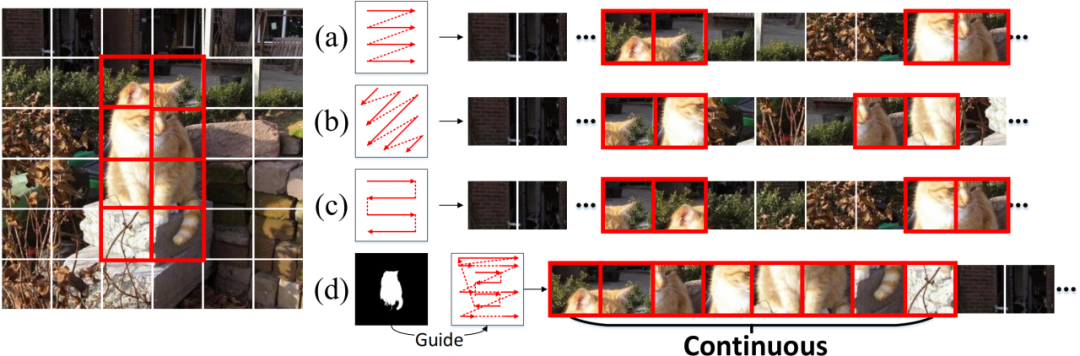
图1 现有扫描策略与本文扫描策略的比较。(a) 以“Z”形模式顺序扫描图像块。(b) 以对角线方向顺序扫描图像块。(c) 以“S”形模式顺序扫描图像块。(d) 与(a/b/c)相比,本文的空间邻近扫描(SNS)能够保留显著图像块的空间连续性。
2.方法介绍
本文提出了一种基于Mamba的框架(Saliency Mamba——Samba,谐音自“桑巴”)来处理通用的SOD任务。本文参考了现有的基于Mamba的视觉模型,分析出将Mamba应用于SOD任务所面临的两大挑战:(1)现有Mamba模型内部的扫描策略难以保持显著图像块的空间连续性;(2)由Mamba骨干网络提取出的多层特征难以实现上下文对齐。具体地,针对挑战(1),本文提出一种新颖的显著性引导Mamba模块(Saliency-Guided Mamba Block,SGMB),该模块利用空间邻近扫描算法(SNS)能够保持显著图像块的空间连续性,并通过状态空间模型的全局建模能力来增强特征表示。针对挑战(2),本文提出了一种上下文感知的上采样(Context-Aware Upsampling, CAU)方法,该方法通过一种新颖的图像块配对与排序策略来建模上下文依赖,从而促进层次化特征的对齐与聚合。是一种完全免训练的解决方案,可无缝集成到任意现有自回归视频扩散模型中,无需修改模型主干。其核心通过两大创新模块,针对性解决流式拖拽编辑中的隐分布漂移与上下文干扰两大难题。
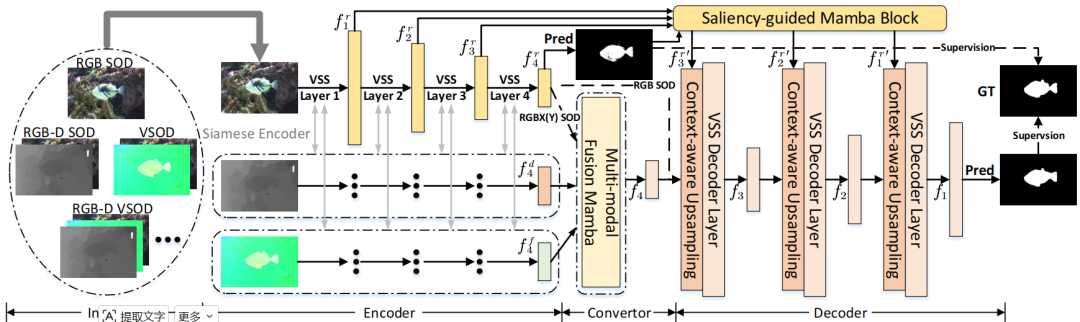
图 2 Samba 模型的总体架构图
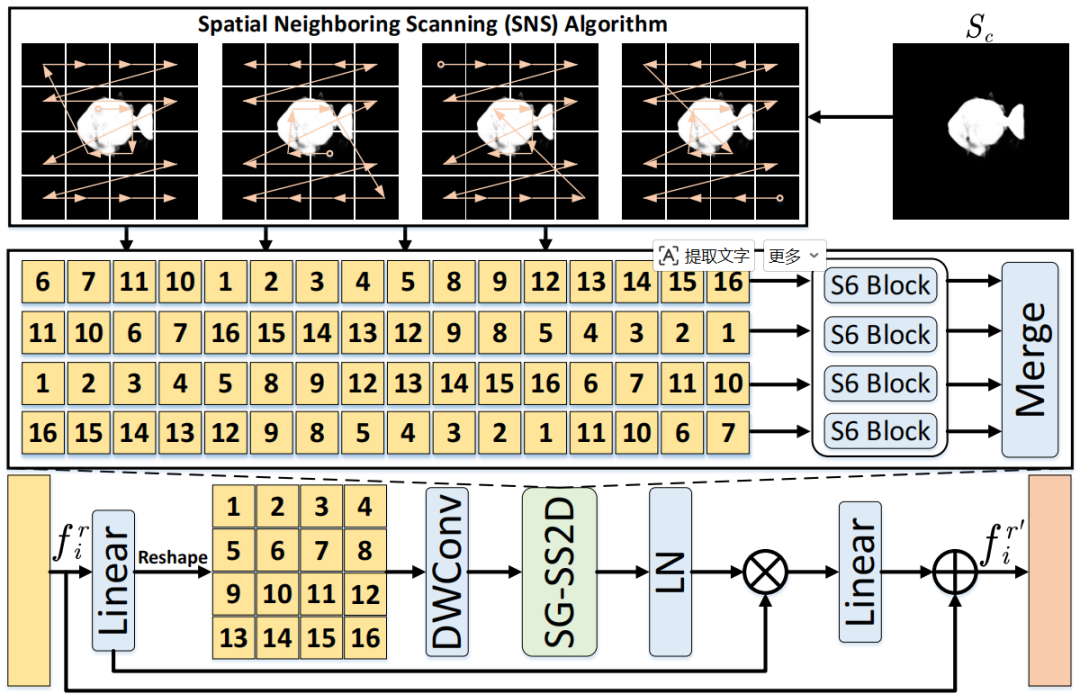
图3 显著性引导Mamba模块(Saliency-Guided Mamba Block,SGMB)
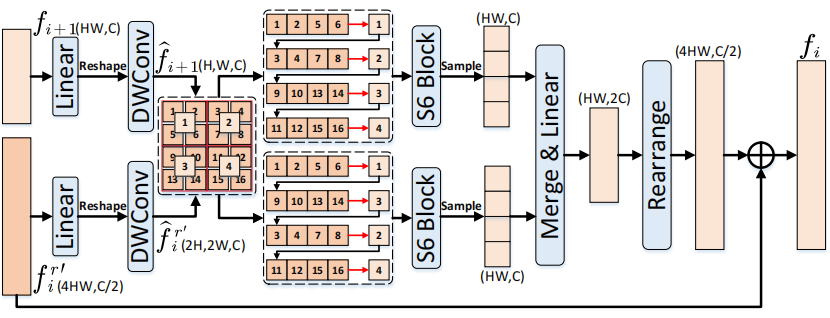
图4 上下文感知的上采样方法(CAU)的结构图
3.实验结果
本文的Samba模型在五个SOD任务上(RGB/RGB-D/RGB-T SOD、视频SOD(VSOD)及RGB-D VSOD)进行了评测,在21个数据集上以较低的模型计算开销取得了最先进的结果,验证了将Mamba应用于SOD任务的有效性,部分实验结果如下:
表1 Samba 与其他先进RGB SOD方法在五个基准数据集上的定量对比结果如下:最优的两个结果分别用红色和蓝色标注
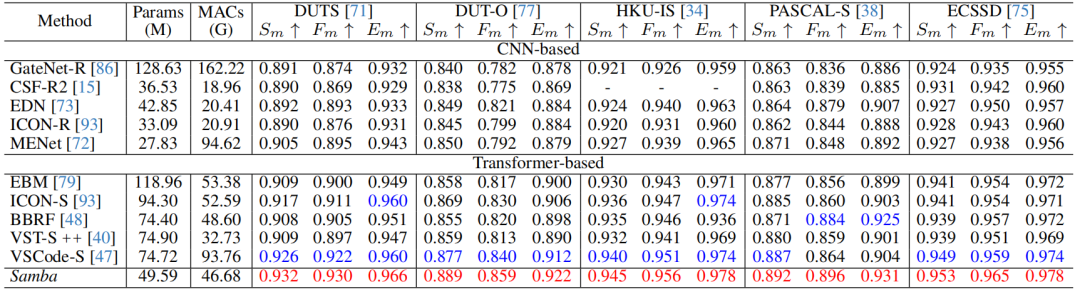
表2 Samba 与其他先进RGB-D SOD方法在五个基准数据集上的定量对比结果如下:最优的两个结果分别用红色和蓝色标注
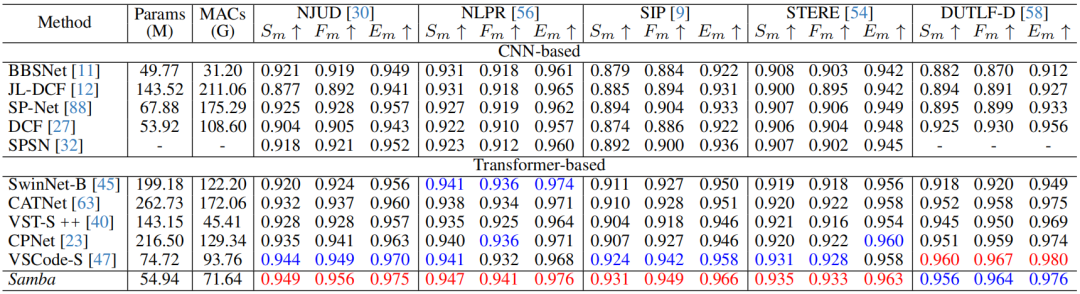
综合结果表明,Samba在21个数据集上均优于现有的基于CNN和Transformer的SOD模型,同时还保持了较低的参数量(Params)和计算量(MACs),充分展示了Samba的优秀性能。
4.总结
本文首次将Mamba应用于SOD任务,提出了一种基于纯Mamba架构的SOD框架(Samba)。Samba中的显著性引导Mamba模块(SGMB)有效增强了显著视觉特征的表示,上下文感知的上采样方法(CAU)促进了层次化特征的对齐与聚合,这两大核心结构显著提升了Samba模型的性能,也为未来Mamba模型的结构设计提供了宝贵的思路。在此基础上,作者进一步提出扩展版本 Samba+,迈出了从任务特定 SOD 模型走向统一 SOD 框架的关键一步。作为首个面向 SOD 任务的统一 Mamba 框架,Samba+ 通过统一建模与多任务联合训练,在单一模型中有效整合不同 SOD 任务及多模态输入的互补信息,不仅显著增强了模型的泛化能力,也取得了更优的整体检测性能。项目代码已开源:https://github.com/wz-zhao/Samba-plus
05
Satellite Observations Guided Diffusion Model for Accurate Meteorological States at Arbitrary Resolution
作者:
涂思危1,费奔2,3,*,杨卫东1,*,零丰华2,陈浩2,陈坤1,2,樊航2,欧阳万里2,3,白磊2
单位:
1复旦大学计算与智能创新学院
2上海人工智能实验室
3香港中文大学
邮箱:
tusiwei906@gmail.edu.cn
benfei@cuhk.edu.hk
wdyang@fudan.edu.cn
论文:
https://ieeexplore.ieee.org/document/11093065/
代码链接:
https://github.com/Tusiwei/SGD
发表会议:CVPR 2025
*共同通讯作者
1.研究背景
从卫星观测中获得的气象状态通常以低分辨率网格场的形式提供,而降尺度是一种在更精细尺度上捕获详细气象数据的有效方法。 对于直接应用空间插值来获得特定位置的气象状态的传统方法,其与实际观测结果相比通常会有显著差异。 对于ERA5再分析数据的降尺度任务,ERA5再分析数据和卫星观测之间存在耦合关系。 卫星观测中的亮温与湿度数据,是影响大气状态的主要因素。 因此,本文提出了一种基于条件扩散模型的卫星观测引导扩散模型SGD,利用条件扩散模型与多元引导生成架构得到更贴合实际场景的高质量精细尺度大气数据。
2.方法介绍
基于条件扩散模型的ERA5数据降尺度框架:SGD(如图1(b)所示)充分考虑了ERA5气象数据与卫星观测变量间的耦合关系。使用预训练的编码-解码结构对GridSat卫星观测的深层特征进行提取作为条件输入。随后,交叉注意力模块被用于进行两者间特征的融合。如图2所示,相较于其他基于超分辨率以及基于插值的降尺度方法,条件数据的引入提供了大气状态的补充视图,使模型能够学习空间和模态之间的复杂关系,确保模型生成结果符合真实气象场景。
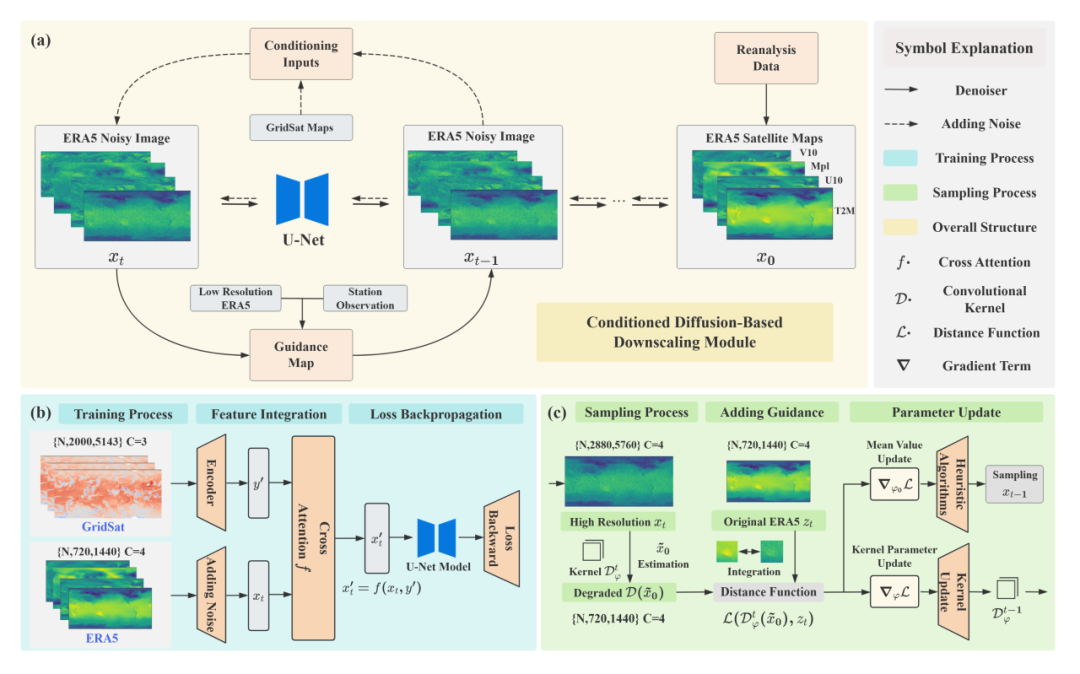
图1 基于条件扩散模型的降尺度框架
多模式引导的高分辨率扩散模块:在采样过程中,模型并非直接对降尺度过程进行建模,而是利用其逆过程来引导高分辨率 ERA5 地图的生成。如图1(c)所示,模型利用低分辨率ERA5数据与weather 5k站点数据集的气象站点数据作为引导,通过构建的距离度量函数以实时衡量生成空间中的高分辨率图像的生成质量。引导信息的引入保障了模型生成结果的细节一致性。同时,距离度量也被用于反向更新逆过程模拟中的可优化参数,保障了后续逆扩散过程中的分辨率转化模拟能力。
3.实验结果
SGD模型在绝大多数ERA5数据变量上超越了现有基于插值与基于扩散模型的主流方法(如图表1所示),通过灵活调整距离度量函数中的引导权重,模型也在气象站点的差异性上实现了有效的优化(如图2所示)。
表1 ERA5降尺度的实验结果
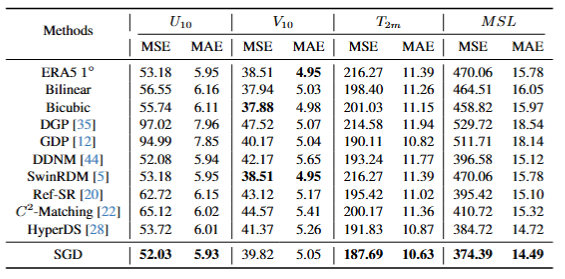
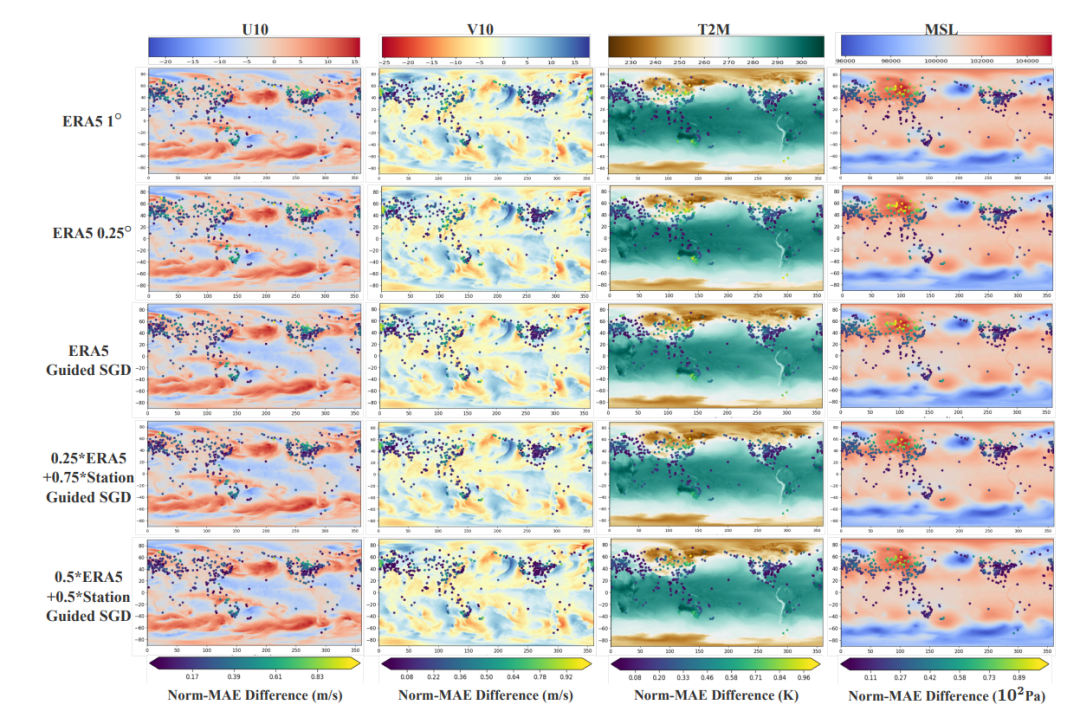
图2 不同距离度量函数降尺度结果的站点数据差异性对比
编辑人:吴建龙、任文琦
专委会责任副主任:张勇东
 京公网安备11010802017125号