【论文导读】2026年论文导读第十三期
【论文导读】2026年论文导读第十三期

论文导读
2026年论文导读第十三期(总第一百五十三期)
目 录
|
1 |
MIGGPT: Harnessing Large Language Models for Automated Migration of Out-of-Tree Linux Kernel Patches Across Versions |
|
2 |
BevSplat: Resolving Height Ambiguity via Feature-Based Gaussian Primitives for Weakly-Supervised Cross-View Localization |
|
3 |
Detection-Friendly Nonuniformity Correction: A Union Framework for Infrared UAVTarget Detection |
|
4 |
EvEnhancer: Empowering Effectiveness, Efficiency and Generalizability for Continuous Space-Time Video Super-Resolution with Events |
|
5 |
Enhanced Visual-Semantic Interaction with Tailored Prompts for Pedestrian Attribute Recognition |
01
MIGGPT: Harnessing Large Language Models for Automated Migration of Out-of-Tree Linux Kernel Patches Across Versions
作者:
党朴成123,黄迪1,李栋123*,陈康4,文渊博1,郭崎1,胡杏13
单位:
1中国科学院计算技术研究所处理器芯片全国重点实验室
2中国科学院大学
3中关村实验室
4清华大学
邮箱:
dangpucheng20g@ict.ac.cn
xirong@ruc.edu.cn
论文:
https://proceedings.neurips.cc/paper_files/paper/2025/file/3760dbb5835bf0b771c3f83cb27ef2c0-Paper-Conference.pdf
代码链接:
https://github.com/CherryBlueberry/MigGPT
发表会议:NeurIPS 2025 Spotlight
*通讯作者
1. 研究背景
本文为NeurIPS 2025 Spotlight论文,聚焦工业界长期存在的Linux内核树外补丁跨版本迁移难题。Linux内核广泛应用于服务器、嵌入式设备等场景,大量树外补丁被用于硬件适配、功能拓展、性能与安全优化,是定制化内核研发的核心支撑。但内核版本持续迭代升级后,旧版本树外补丁会出现兼容性失效问题,传统维护方式高度依赖资深工程师,人工适配周期长达数周,人力成本高昂且效率低下。现有代码迁移技术多基于固定规则,仅支持简单API迭代、CVE漏洞补丁回滚等基础场景,无法处理命名空间变更、函数调用冲突、控制与数据流依赖等复杂内核变更场景,且普遍预设目标代码位置已知,完全无法适配真实的树外补丁迁移场景。同时,原生大语言模型直接用于补丁迁移时,存在代码结构误判、片段边界模糊、碎片化代码遗漏、迁移点位定位不准等诸多问题,整体迁移成功率极低,难以落地使用。
2. 方法介绍
针对上述痛点,本文提出全新自动化迁移框架MigGPT,首次实现大语言模型在Linux树外内核补丁跨版本迁移场景的高效落地。整套方法摒弃复杂公式设计,依托轻量化代码结构优化与多模块协同策略,适配公众号传播与工程落地需求。研究核心创新为设计了轻量级代码指纹结构,突破传统抽象语法树的应用局限,可高效处理不完整代码片段,完整保留内核代码中的注释、内联汇编等关键信息,精准提取代码结构、函数特征与位置信息,为大模型提供完整、精准的迁移上下文,从根源解决模型代码理解偏差问题。基于代码指纹结构,MigGPT搭建三大核心功能模块,形成贴合工业实际的双阶段迁移流程。检索增强模块可规避相似代码结构干扰,自动补全内核迭代中碎片化的代码片段;检索对齐模块精准锁定代码片段首尾边界,消除模型识别的边界偏差;迁移增强模块精准定位补丁修改点位、梳理修改范围。整套框架将复杂的补丁迁移任务拆解为新版内核代码检索、补丁适配迁移两个核心步骤,大幅提升迁移精度与稳定性。
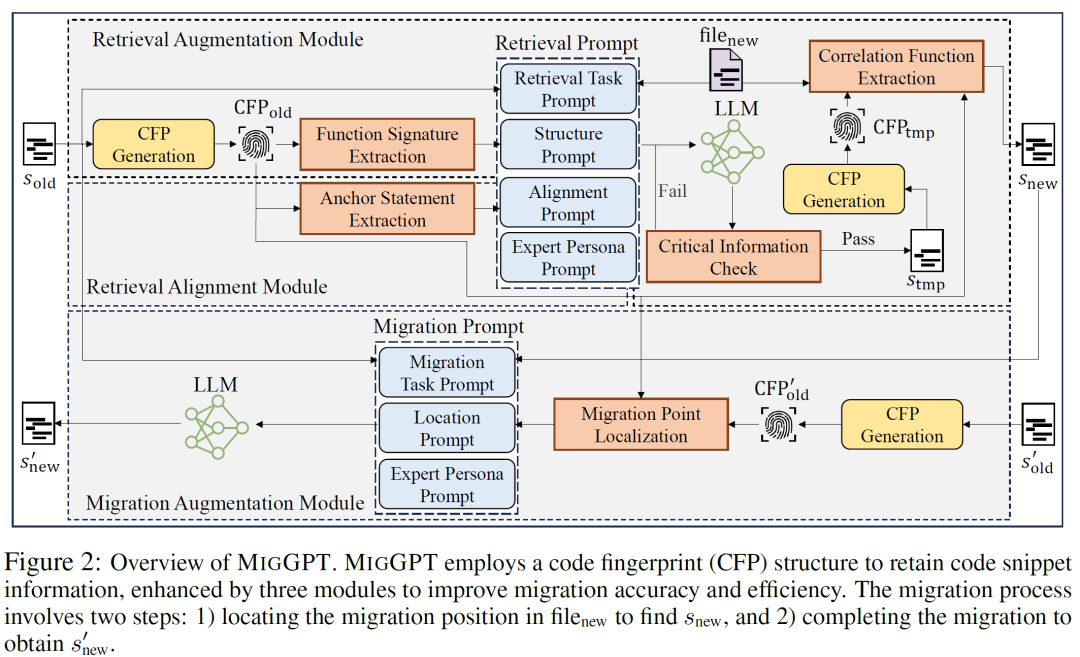
图1 MIGGPT的总览图
3. 实验结果
为科学评测模型性能,研究团队基于RT-PREEMPT、树莓派Linux、HAOC三大真实开源内核项目,搭建了业内首个树外内核补丁迁移基准数据集,包含135组高低难度样本,全面覆盖无冲突修改、代码冲突修改两类主流迁移场景,可为后续相关研究提供统一评测标准。实验适配GPT系列、DeepSeek、Llama等多款主流开源与闭源大模型,测试结果表现优异。MigGPT平均补丁迁移完成率达到74.07%,相比原生大模型直接使用的效果提升45.92%,精度提升幅度显著。在效率层面,该框架仅需人工专家平均耗时的2.08%,极大压缩了内核补丁迭代周期,且模型查询次数仅小幅增加,无额外高额算力开销。此外,该框架具备优秀的泛化能力,在Linux驱动补丁迁移任务中适配性良好,经过简单改造后还可支持Python代码迁移,跨场景、跨语言适配能力突出,同时补丁编译成功率远优于传统代码迁移算法,工程实用性极强。
表1 模态大模型在三个幻觉数据集(POPE、AMBER和PhD)上的评测结果
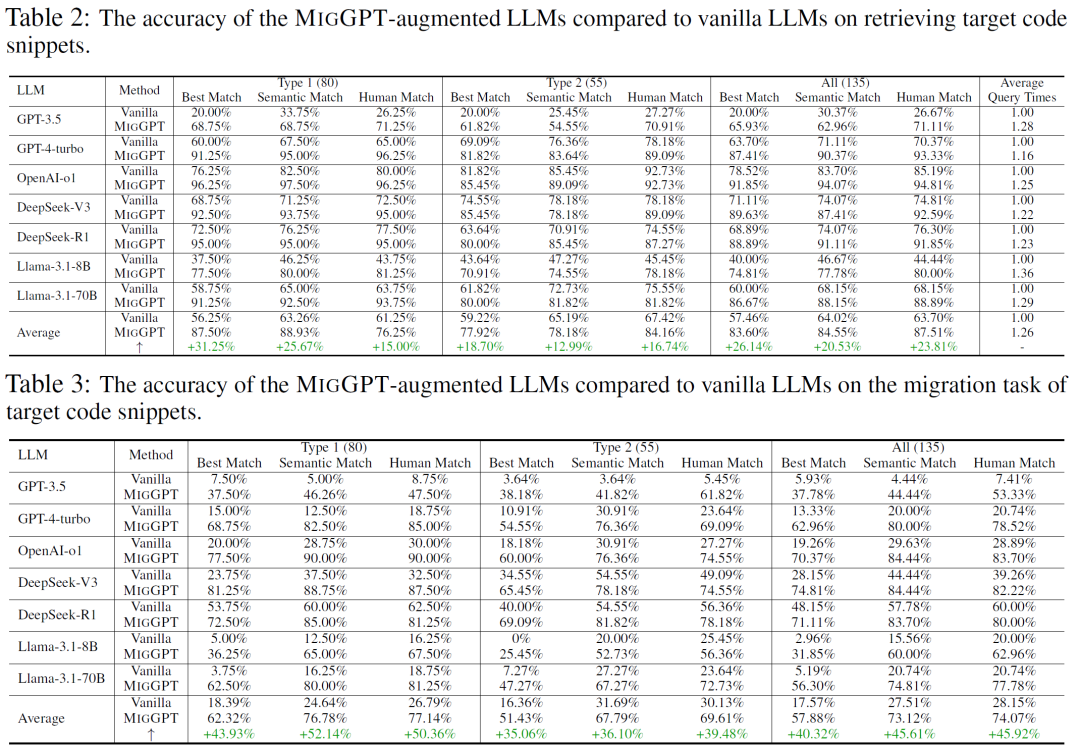
表2 实验结果图
02
BevSplat: Resolving Height Ambiguity via Feature-Based Gaussian Primitives for Weakly-Supervised Cross-View Localization
作者:
Qiwei Wang1,Shaoxun Wu1,Yujiao Shi1*
单位:
1上海科技大学
邮箱:
wangqw2024@shanghaitech.edu.cn
wushx@shanghaitech.edu.cn
shiyj2@shanghaitech.edu.cn
论文:
https://arxiv.org/abs/2502.09080
代码链接:
https://github.com/wangqww/BevSplat
发表会议:NeurIPS 2025 Spotlight
*通讯作者
1.研究背景
跨视角定位旨在根据一张地面图像,在卫星或航拍图像中估计相机位置和朝向,是自动驾驶、无人机导航和地理空间分析中的关键问题。实际场景中,高精度位姿标注成本很高,而普通 GPS 标注往往存在数米到数十米误差,因此弱监督跨视角定位近年来受到关注。该任务的核心难点在于地面视角与卫星视角之间存在尺度、视角和遮挡差异。许多方法会先把地面图像转换为鸟瞰视角,但常用逆透视映射默认世界是平坦地面,容易把车辆、树木、建筑等非地面物体投影到错误位置;复杂 Transformer 则在噪声标签下训练困难。
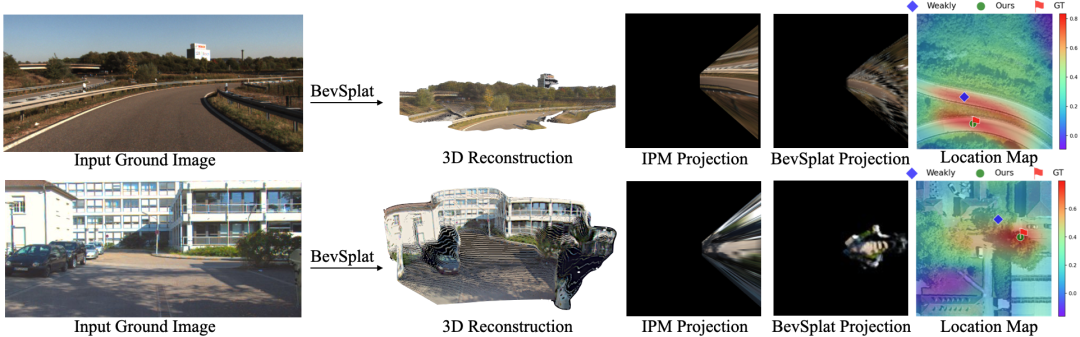
图1 BevSplat 通过三维重建和高斯渲染,将地面图像转换为更适合卫星图像匹配的 BEV 表示
2.方法介绍
本文提出 BevSplat,用特征高斯基元显式建模地面图像中的三维结构,缓解从地面视角投影到鸟瞰视角时的高度歧义。BevSplat 首先利用预训练深度模型从单张地面图像估计深度,并把像素提升到三维空间;随后,每个像素会生成多个三维高斯基元。与传统 3D Gaussian Splatting 主要渲染颜色不同,BevSplat 将 DINOv2 和 DPT 提取到的语义特征及置信度绑定到高斯基元上,再从鸟瞰视角渲染得到地面图像对应的 BEV 特征图。最后,方法在卫星图像特征和地面 BEV 特征之间进行相似度匹配,估计相机相对于卫星图的位置。
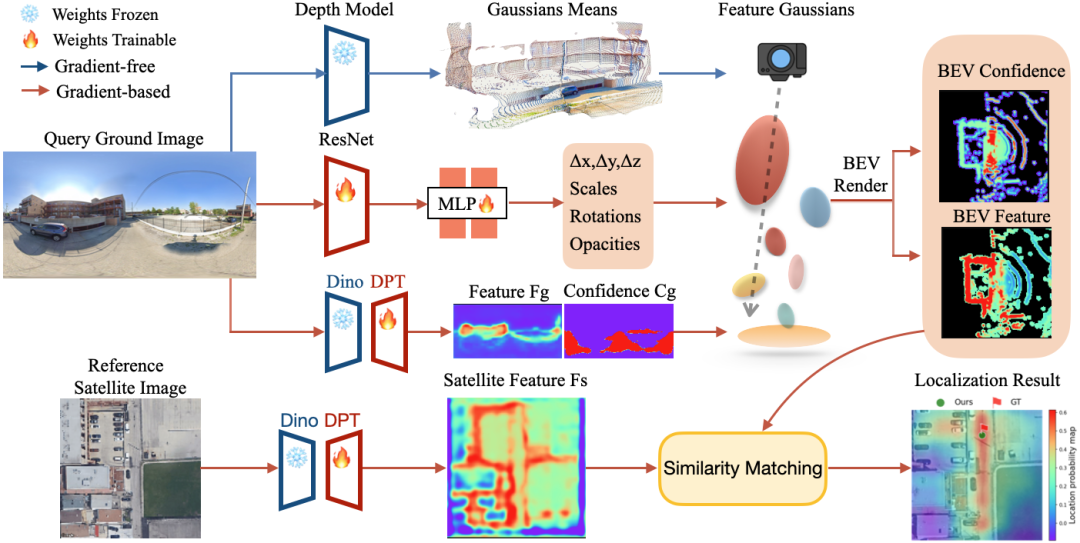
图2 BevSplat 整体框架:深度模型提供初始三维位置,网络预测高斯基元属性,语义特征与置信度被绑定到高斯基元后渲染为 BEV 特征,并与卫星图像特征匹配完成定位
3.实验结果
本文在 KITTI 和 VIGOR 常用数据集上验证方法有效性,其中 KITTI 使用前视针孔相机图像,VIGOR 使用城市级全景图像,并覆盖同区域和跨区域测试。实验表明,BevSplat 相比弱监督基线 G2SWeakly 在平均误差和中位误差上均有明显下降;在 KITTI 跨区域测试中,BevSplat 甚至在平均和中位定位误差上超过多种全监督方法。在 VIGOR 上,BevSplat 同样缩小了弱监督与全监督方法之间的性能差距。消融实验表明,相比 IPM、直接点云投影、Lift-Splat-Shoot 和 OrienterNet 等 BEV 生成方式,特征高斯基元渲染能生成更连续、更符合真实道路结构的 BEV 表示。
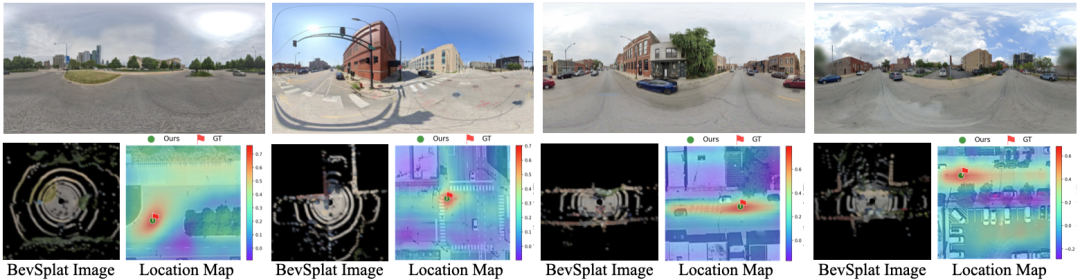
图3 VIGOR 数据集上的定位可视化。每组样例上方为查询地面图像,下方左侧为 BevSplat 根据估计高斯基元生成的 BEV 图像,下方右侧为相对于卫星图像的定位结果。
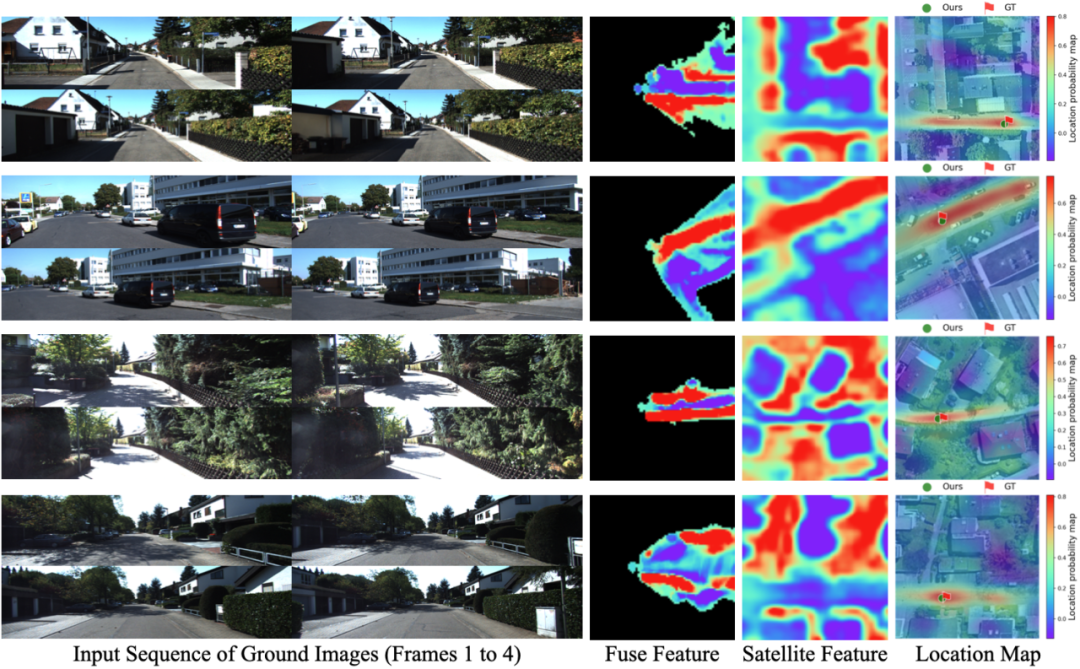
图4 KITTI 数据集上的多帧定位可视化。BevSplat 能够聚合时间维度上的多帧信息,并过滤车辆等动态元素,从而获得更稳健的定位结果。
4.总结
BevSplat 的意义在于,它在仅依赖普通图像和弱监督定位信号的条件下,引入显式三维高斯表示来处理地面-卫星跨视角匹配中的高度歧义和遮挡问题,为弱监督跨视角定位提供了一条兼顾几何可解释性、表达能力和实际可扩展性的路线。该方法有望服务于低成本自主导航、GPS 不可靠场景下的机器人定位和地理空间智能等应用,代码已公开,有助于后续研究复现和扩展。
03
Detection-Friendly Nonuniformity Correction: A Union Framework for Infrared UAVTarget Detection
作者:
方厚章1,†,*,王啸林1,†,李曾阳1,王璐1,李青山1,昌毅2,颜露新2
单位:
1西安电子科技大学
2华中科技大学
邮箱:
wanglu@xidian.edu.cn
yanluxin@hust.edu.cn
论文:
https://doi.org/10.1109/CVPR52734.2025.01111
代码链接:
https://github.com/IVPLaboratory/UniCD
发表会议:CVPR 2025(Highlight)
*共同通讯作者
†共同第一作者
1.研究背景
红外成像具有全天时、抗光照干扰等优势,是无人机监视与反无人机感知中的重要技术路线。然而,在实际红外成像过程中,由于光学镜头、相机外壳等部件的热辐射影响,采集到的红外图像常常会出现温度相关的低频非均匀性,即偏置场。偏置场会显著降低图像对比度,使原本尺寸小、纹理弱的无人机目标进一步淹没在复杂背景中,从而增加漏检和误检风险。现有方法通常采用直接检测或“先校正、后检测”的分离式流程,但前者难以应对严重退化,后者则缺少检测任务反馈,校正后的图像未必真正有利于目标检测。
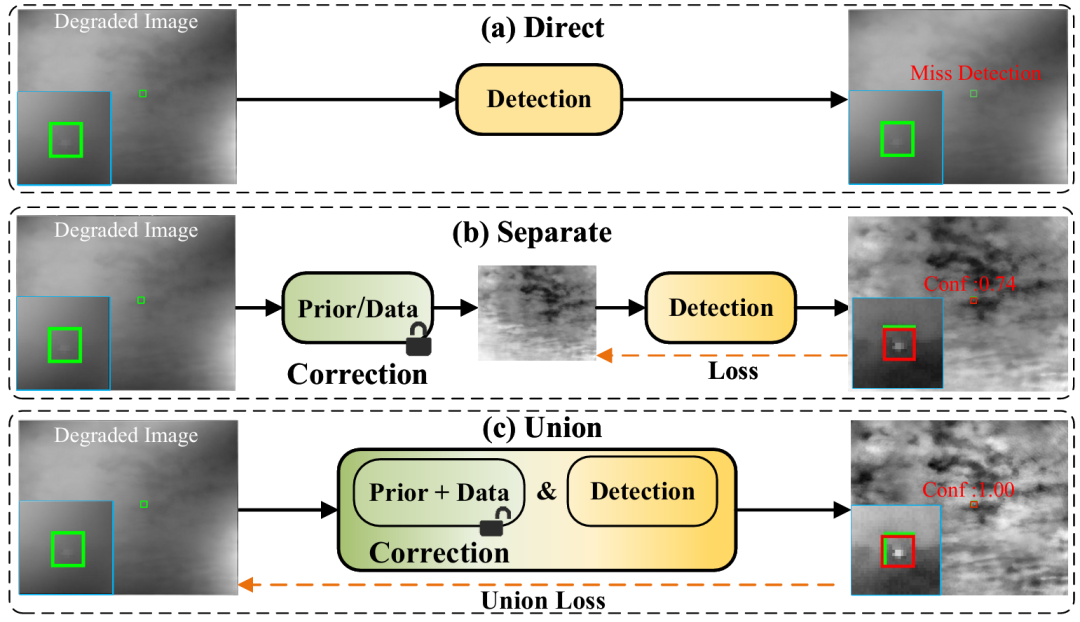
图1 三类红外无人机目标检测策略对比,包括直接检测、分离式校正检测和本文的统一框架
2.方法介绍
本文提出面向检测友好的红外非均匀性校正统一框架 UniCD,将偏置场校正和无人机目标检测整合到同一端到端流程中。输入的红外退化图像首先经过轻量化偏置场预测模块,估计图像中的低频非均匀性成分;随后从原图中去除该偏置场,得到校正图像;最后将校正图像送入无人机目标检测网络完成目标定位。与传统分离式流程不同,UniCD 在训练过程中能够利用检测任务的反馈约束校正模块,使校正结果不仅视觉上更清晰,也更有利于检测器识别弱小无人机目标。
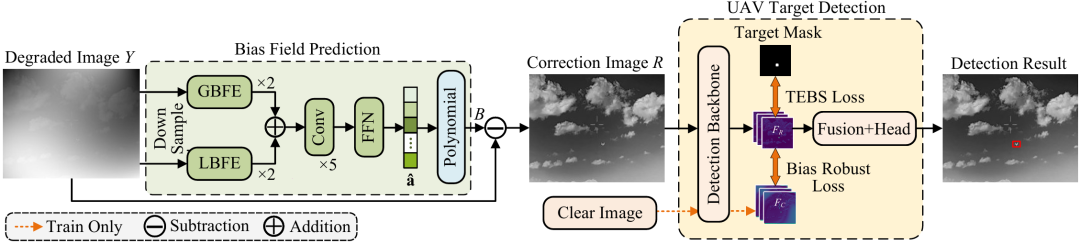
图2 UniCD整体框架图
校正模块设计上,本文充分利用红外偏置场空间平滑、低频变化的物理特性,没有直接使用复杂网络预测整幅清晰图像,而是将偏置场表示为由高阶多项式控制的低维模型。网络需要学习的不是每个像素的校正结果,而是少量能够描述偏置场形态的参数,从而降低学习难度并提升效率。此外,本文还引入目标增强与背景抑制约束,以及检测引导的特征一致性约束,使校正过程更关注检测有用信息。本文同时构建了红外偏置场无人机检测基准 IRBFD,包含 30,000 张合成非均匀红外图像和 20,000 张真实非均匀红外图像,覆盖多类复杂背景和多尺度无人机目标。
3.实验结果
实验结果表明,UniCD 在合成数据集 IRBFD-syn 和真实数据集 IRBFD-real 上均取得最佳整体表现。在 IRBFD-syn 上,UniCD 的 PSNR 达到 31.961,SSIM 达到 0.9827,检测精确率达到 0.999,召回率达到 0.822,同时具备 32 FPS 的实时处理能力。在 IRBFD-real 上,UniCD 的信杂比增益 SCRG 达到 1.286,检测精确率达到 0.994,召回率达到 0.901,均优于对比方法。总体来看,UniCD 验证了“红外图像校正不应只追求视觉恢复效果,更应服务于下游检测任务”的核心思想。
表1 IRBFD-syn 上与 SOTA 方法的定量对比结果
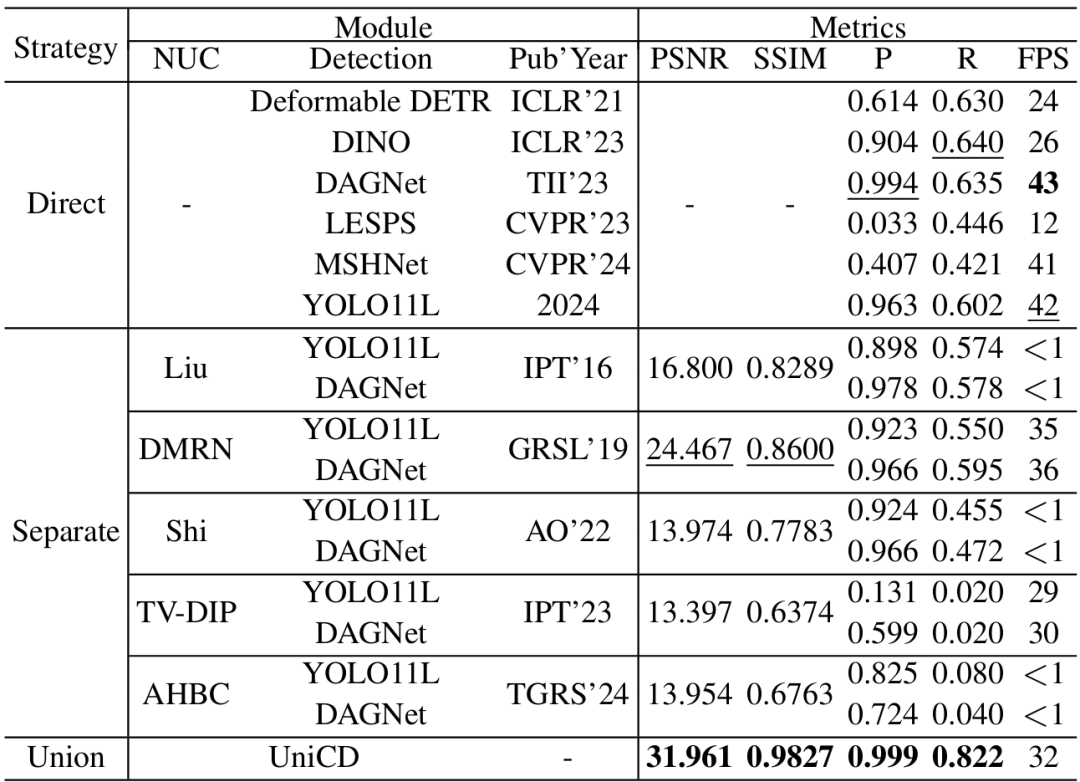
表2 IRBFD-real上上UniCD与 SOTA 方法的定量对比结果
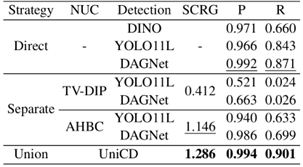
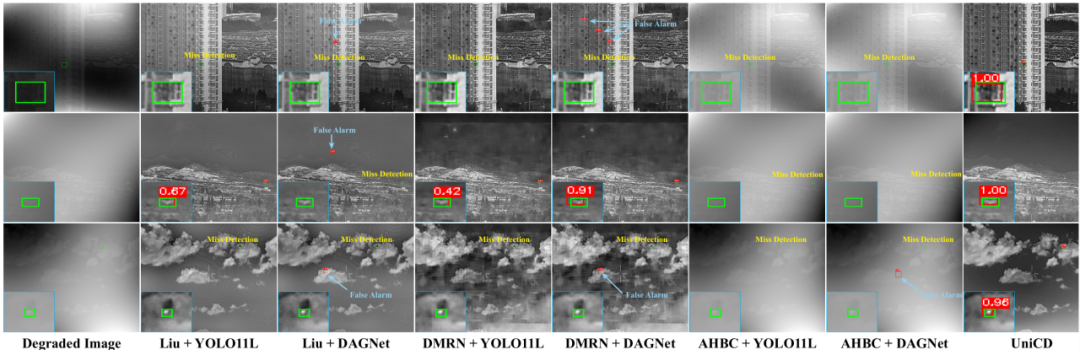
图3 IRBFD-syn 上UniCD与 SOTA 方法的定性对比结果
04
EvEnhancer: Empowering Effectiveness, Efficiency and Generalizability for Continuous Space-Time Video Super-Resolution with Events
作者:
魏硕彦1,李锋2,*,唐申庚2,赵耀1,白慧慧1,*
单位:
1北京交通大学
2合肥工业大学
邮箱:
shuoyan.wei@bjtu.edu.cn
fengli@hfut.edu.cn
tangsg@hfut.edu.cn
yzhao@bjtu.edu.cn
hhbai@bjtu.edu.cn
论文:
https://arxiv.org/abs/2505.04657
代码链接:
https://github.com/W-Shuoyan/EvEnhancer
发表会议:CVPR 2025 Highlight
*共同通讯作者
1.研究背景
连续视频时空超分辨率旨在从低分辨率、低帧率视频中重建任意空间尺度与时间尺度的高质量视频。然而,由于传统视频帧只记录稀疏时刻的视觉观测,帧间细粒度动态信息往往缺失,使得模型难以准确合成潜在的中间时刻特征。与此同时,现有基于隐式神经表示的方法虽然能够支持连续尺度重建,但通常倾向于分别建模空间连续域与时间连续域,难以充分利用时空相关性,在复杂运动、非线性运动以及训练分布外尺度下容易出现重建质量下降的问题。鉴于事件流具有高时间分辨率、高动态范围和低延迟等优势,能够补充传统帧相机在帧间缺失的运动线索,本文提出了一种事件驱动的连续视频时空超分辨率框架EvEnhancer,利用事件信息引导合成潜在的帧间特征,并在时空域上学习统一的隐式神经表示,从而实现任意空间尺度和时间尺度下更加有效、高效且具有泛化能力的连续视频时空超分辨率。
2.方法介绍
如图1所示,EvEnhancer主要由事件自适应合成模块(EASM)和局部隐式视频Transformer(LIVT)组成。EASM用于利用事件信息引导潜在帧间特征合成,其中事件调制对齐(EMA)通过金字塔级联可变形卷积网络,对参考帧特征分别进行前向和后向调制对齐,使每个事件体素网格分段提供的细粒度运动线索能够参与特征偏移与调制,从而获得更准确的潜在帧间特征;在此基础上,双向循环补偿(BRC)进一步结合通道注意力机制和双向循环网络,将对齐后的帧特征与事件特征进行全局补偿。随后,LIVT在目标分辨率网格的查询坐标与原分辨率网格的三维近邻坐标之间计算跨尺度时空注意力,以建模空间细节与时间运动的上下文依赖;同时对相对时空坐标进行余弦位置编码,使模型能够聚合局部采样特征并直接预测任意时空位置的RGB值,从而形成统一的连续视频表示。此外,LIVT通过时域平面展开机制将三维注意力图展平为二维注意力图,在保持时空建模能力的同时降低显存开销,支持高效的任意尺度重建。
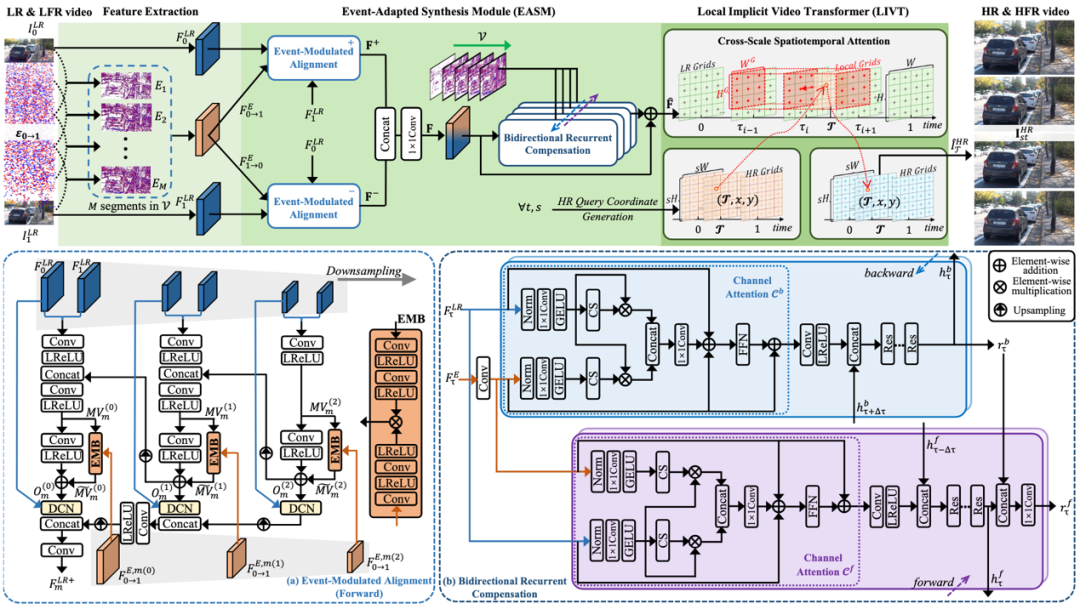
图 1 EvEnhancer方法框架图
3.实验结果
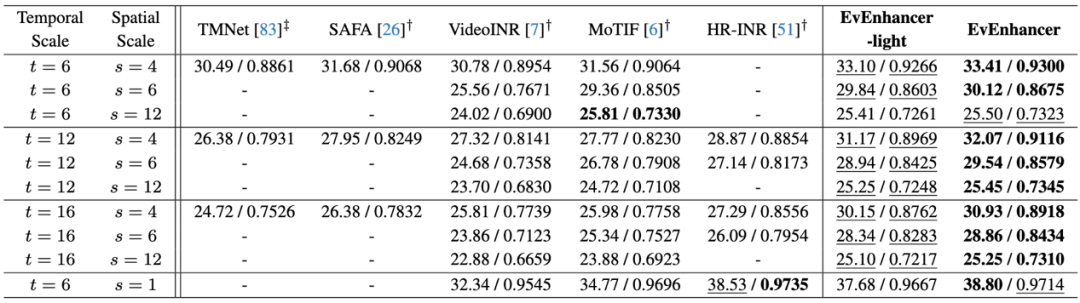
本文在合成事件数据集Adobe240、GoPro和真实事件数据集BS-ERGB、ALPIX-VSR上进行实验。图2从跨数据集鲁棒性、不同放大尺度泛化性和中间帧重建结果三个角度直观展示了EvEnhancer相较先进连续视频时空超分辨率方法的优势。表1给出了分布内时空尺度的定量结果,EvEnhancer在GoPro-Center、GoPro-Average、Adobe240-Center和Adobe240-Average四个设置下均取得最佳PSNR,并且仅使用6.55M参数,在重建质量和模型效率之间具有更好平衡。表2进一步展示了GoPro数据集上分布外时空尺度的结果,EvEnhancer在不同时空尺度组合上整体优于现有方法,尤其在较大时间放大倍率下表现更加稳定,验证了模型突出的泛化能力。
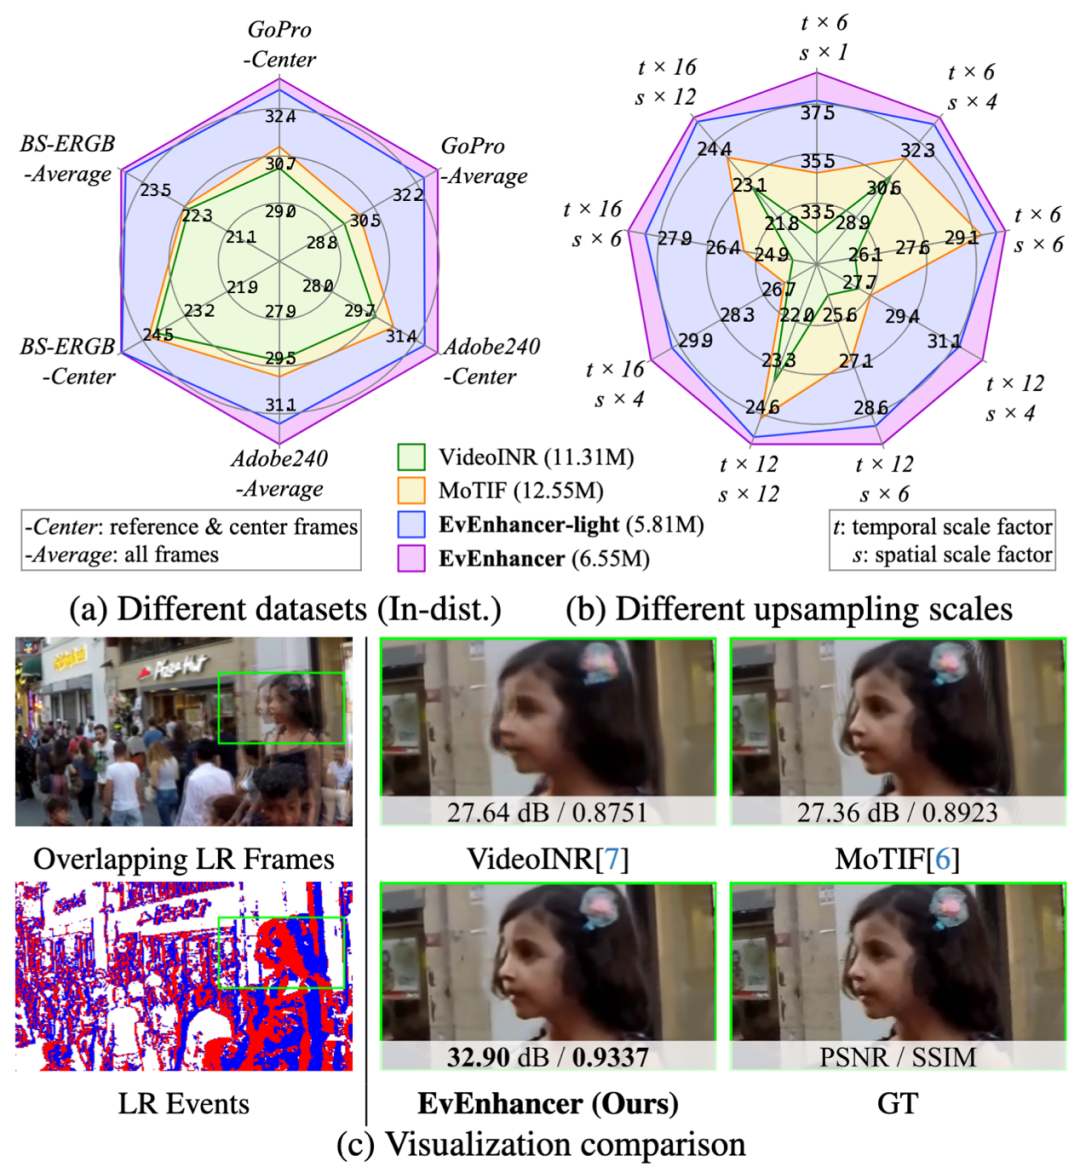
图2 不同连续视频时空超分辨率方法可视化结果比较
表1 分布内尺度视频时空超分辨率定量结果比较
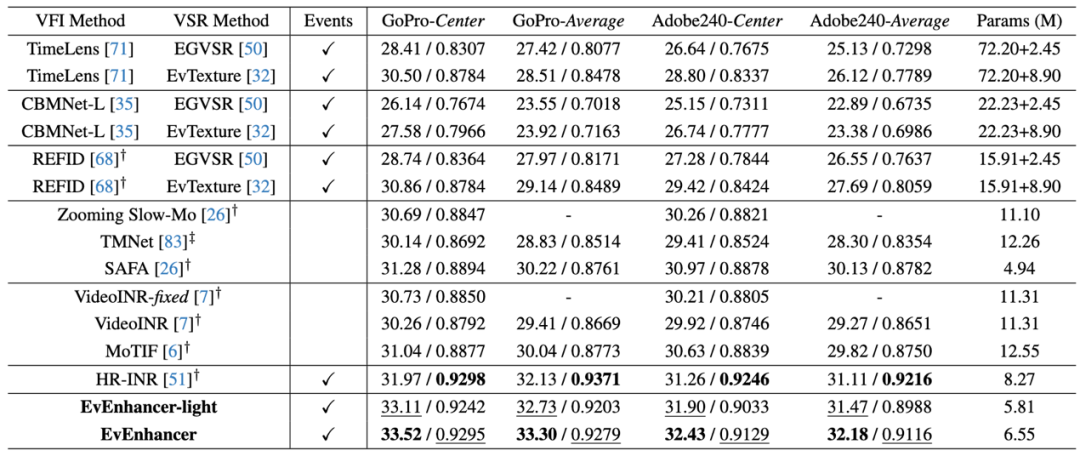
表2 分布外尺度视频时空超分辨率定量结果比较
4.总结
本文提出了一种事件驱动的连续视频时空超分辨率方法EvEnhancer,通过事件自适应合成模块学习长程运动轨迹,并通过局部隐式视频Transformer构建统一的连续时空表示。实验结果表明,本文方法不仅在常规同分布尺度上取得更优重建质量,也在分布外尺度和真实事件数据上表现出更好的泛化性与鲁棒性。本文证明了事件流对于连续视频时空超分辨率具有重要价值,为高质量、高效率的任意尺度视频增强提供了新的技术路径。
05
Enhanced Visual-Semantic Interaction with Tailored Prompts for Pedestrian Attribute Recognition
作者:
吴俊毅1,黄延2*,高敏3,牛玉贞1,陈羽中1*,吴强4
单位:
1福州大学, 计算机与大数据学院
2悉尼科技大学, 澳大利亚人工智能研究院
3福州大学, 物理与信息工程学院
4悉尼科技大学, 电气与数据工程学院
邮箱:
junyi.wu-1@outlook.com
yan.huang-7@uts.edu.au
min.gao-1@ outlook.com
yzchen@fzu.edu.cn
qiang.wu@@uts.edu.au
论文:
https://10.1109/CVPR52734.2025.00894
发表会议:CVPR 2025
*共同通讯作者
1.研究背景
行人属性识别(PAR)是智能监控、行人重识别等领域的关键技术,旨在从图像中准确预测行人的年龄、性别、服装、配件等多个属性。然而,现有方法面临两大难题:一是行人属性存在显著的类内变异性,传统单模态视觉方法难以捕捉复杂变化;二是多模态方法(如基于CLIP的VTB和PromptPAR)虽引入提示学习,但依赖静态固定模板且仅通过简单拼接融合模态,语义利用不充分。同时,现有PAR数据集多采集于单一场景和季节,难以适应真实世界需求。
2.方法介绍
针对现有多模态PAR方法中静态提示模板和浅层模态融合的问题,本文提出了一种增强视觉-语义交互的定制化提示框架(EVSTIP,如图1所示)。该框架以CLIP模型为基础,充分利用视觉和语言模态的优势,核心设计了三个关键模块:一是图像条件双提示初始化模块(IDIM),它将三组固定提示模板与一组可学习提示相结合,通过组内注意力捕捉属性共现关系,并利用图像条件交叉注意力机制,让视觉特征指导文本提示生成,为每个具体图像产生上下文敏感、细粒度定制化的描述,有效应对属性类内变化;二是提示增强与正则化模块(PERM),通过跨组注意力进一步融合多组提示特征,挖掘不同模板间的互补信息,同时引入正则化损失约束可学习提示,避免过拟合训练数据;三是双模态互交互模块(BMIM),实现视觉与语言特征的双向深度交互(包括视觉引导语言交互VLII和语言引导视觉交互LVII),并引入视觉-语言共享token,进一步促进模态间的有效交互与深度融合,大幅提升特征表示能力。
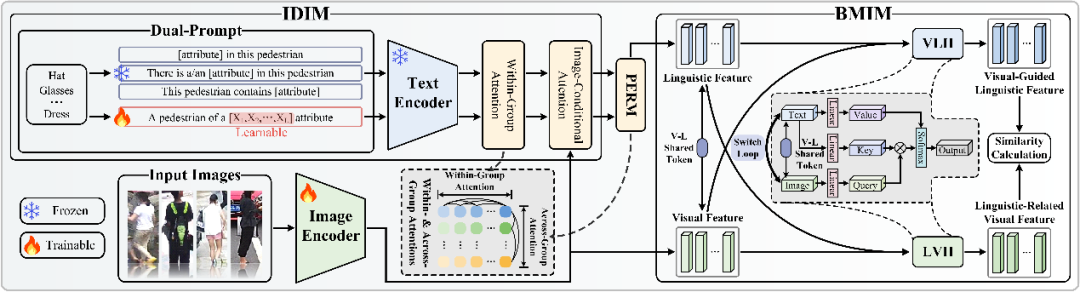
图1 EVSTIP总体框架示意图
为验证方法在真实场景中的有效性,作者基于Long-term行人重识别数据集Celeb-reID标注构建了Celeb-PAR数据集(见表1 Celeb-PAR和现有PAR数据集对比)。该数据集包含34,186张图像、41个属性,训练与测试集行人ID完全不重叠,且覆盖多种季节、场景和服装变化,显著提升了数据集的多样性和挑战性(见图2 Celeb-PAR数据集样例)。
表1 Celeb-PAR和现有PAR数据集对比
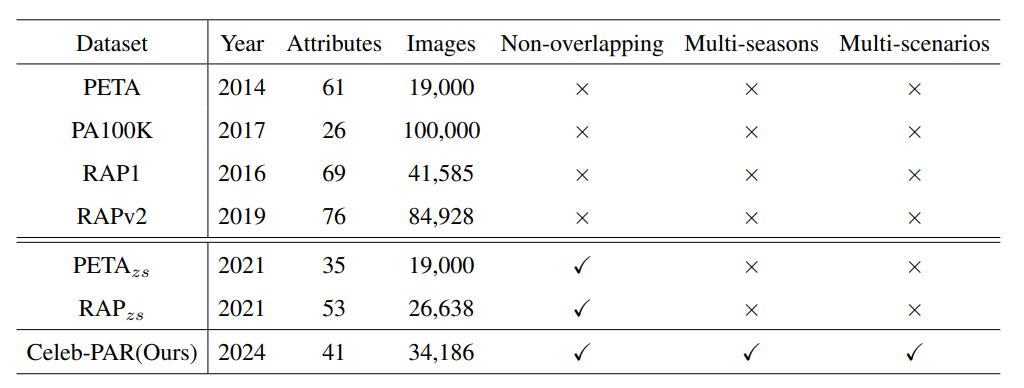
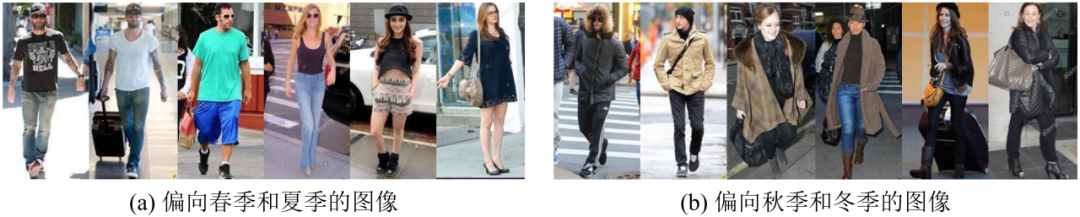
图2 Celeb-PAR数据集样例
3.实验结果
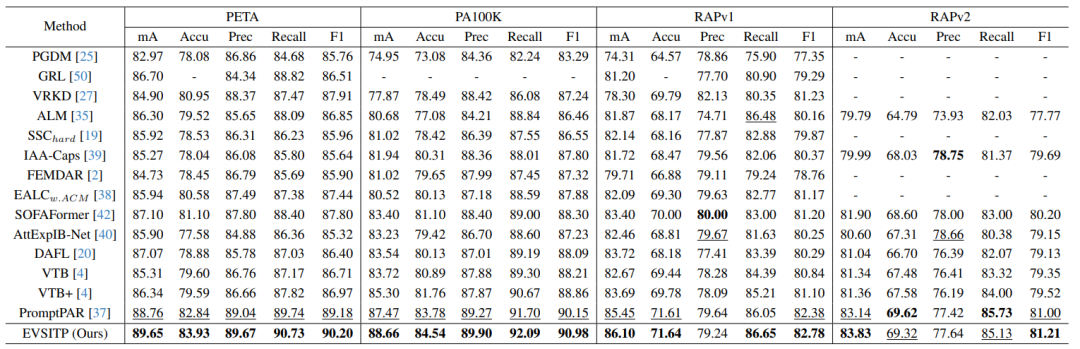
实验结果如表2显示,EVSTIP在PETA、PA100K、RAPv1和RAPv2四个基准数据集上均取得SOTA性能,mA指标相比PromptPAR提升0.65%-1.19%。在新构建的Celeb-PAR数据集上同样表现优异。消融实验验证了各模块的有效性,双向交互和正则化显著提升了模型鲁棒性。
表2 EVSTIP在各数据集上的实验结果
4.总结
本文提出的EVSTIP框架通过图像条件定制化提示和双模态深度交互,有效解决了现有PAR方法中静态模板和浅层融合的不足,显著提升了属性识别的准确性和泛化能力。同时,新数据集Celeb-PAR为社区提供了更贴近真实场景的基准。未来,该方法有望进一步扩展到更多多模态视觉任务中,为智能监控和人机交互提供更强大的技术支撑。
编辑人:吴建龙、任文琦
专委会责任副主任:张勇东
 京公网安备11010802017125号